Stanford 最近开了一门叫 CS146S(The Modern Software Developer)的课,讲现代 AI 原生软件开发:从 LLM 基础到 Agent,从 Prompt Engineering 到安全部署,材料完全公开。打算按这门课的节奏,一边学一边写。这篇对应 Week 1:LLM 基础与 Prompt Engineering。
思维导图
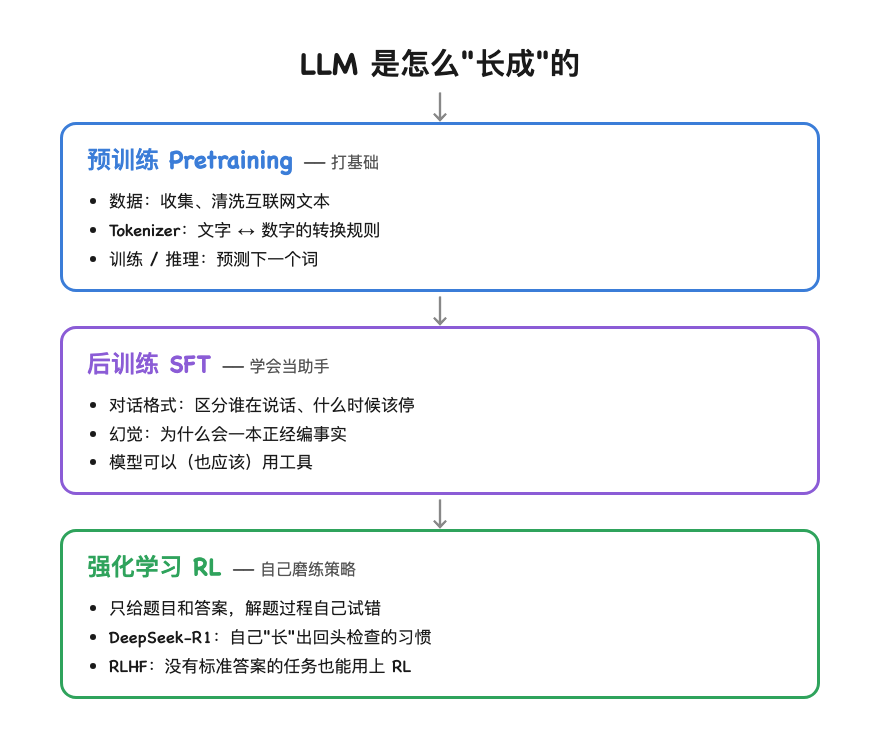
LLM 是什么:预训练、后训练、强化学习分别在干嘛
一个 LLM 是怎么”长成”的,可以先记住三个阶段,后面每一节都会展开讲:
- 预训练(Pretraining):把互联网上能收集到的文字喂给模型,让它反复练习”看了前面的内容,猜下一个词是什么”,这是打基础的阶段,很像看课本正文、积累背景知识。
- 监督微调(SFT):给模型看一批”问题+标准答案”的示范对话,让它学会像一个助手一样一问一答,很像看课本里的例题。例题不光给答案,还演示完整的解题过程,照着模仿就行。
- 强化学习(RL):只给模型问题和最终答案,解题过程不给,让模型自己反复尝试、试错,蒙对的思路才会被保留下来,很像做课后习题。习题册通常只在书后面附答案,具体怎么推出来,要自己一遍遍试。
这三个阶段像是一层层往上叠:预训练打基础,SFT 教它守规矩、像人一样对话,RL 让它在能验证对错的地方自己磨练出更好的策略。
预训练(Pretraining)
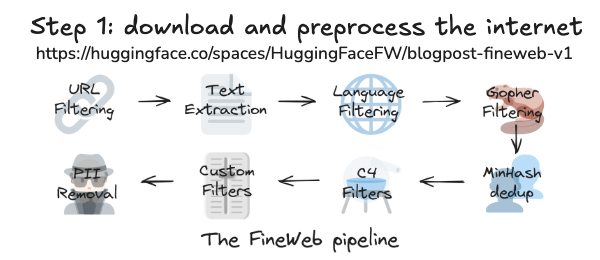
预训练第一步是给模型准备学习材料,主要来自互联网,但要经过几道过滤才能用:
- 挑来源、提正文、选语言:筛掉不该要的网站,提取网页里的文字,只留目标语言。
- 两轮质量清洗:先挑掉没营养的内容(导航栏文字、凑字数的垃圾页面),再补漏删掉格式错乱或大段重复的网页。
- 去重:网上同一篇文章常被转载多份,用 MinHash 技术只留一份。
- 去隐私:清掉邮箱、电话这类信息。
这套流程来自 FineWeb 数据集,不同团队做法不同,也会随时间调整。
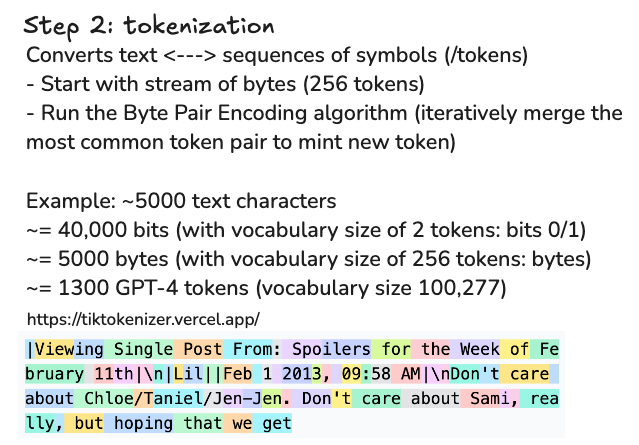
Step 1 拿到的文字数据,神经网络其实没法直接处理。它只会做数字运算,不认字母、标点或汉字。所以要有一套规则,把文字先转换成一串数字,算完之后再转换回文字。这套转换规则就是 Tokenizer,每个数字(ID)对应一个 Token。
Token 具体是怎么切出来的?做法叫 BPE(Byte Pair Encoding):先把文字拆成最小单位,也就是 256 种字节(byte),然后反复找”哪两个单位最常一起出现”,把它们粘成一个新的 Token,粘够了预先定好的数量就停手。GPT-4 的 Tokenizer 大概停在 10 万(准确数字是 100,277)这个规模。
为什么是 10 万左右?这是权衡出来的结果,不是必然。词表越大,同一段话需要的 Token 数就越少:图里给了一个具体对比——大约 5000 个字符的文字,如果只用 0/1 两种符号表示要 4 万个数字,用 256 种字节表示要 5000 个,换成 GPT-4 的 Tokenizer 只要 1300 个左右,效率提升很明显。但词表越大,模型每一步要处理和输出的选项也越多,会变得更重。10 万左右是目前主流模型摸索出来的一个平衡点。
图里那段论坛帖子的彩色示例很能说明问题:像”the”、” of”、” but”、” that”这类常见词,整个词正好是一个 Token;但”February”、” really”这种长一点、不那么常见的词,会被拆成”Fe”+“bruary”、“rea”+“lly”这样的两三块。很多人以为 Token 就是一个字母,看了这个例子就知道不是这么回事。这也是”strawberry 里有几个 r”这类问题模型经常答错的原因。
另外要知道,Tokenizer 不是全世界通用一套,不同公司、不同模型往往用不同的 Tokenizer,切法也不一样。想直观感受这个过程,可以去 tiktokenizer.vercel.app 拿自己的一段文字试试,看它到底被切成了什么样。
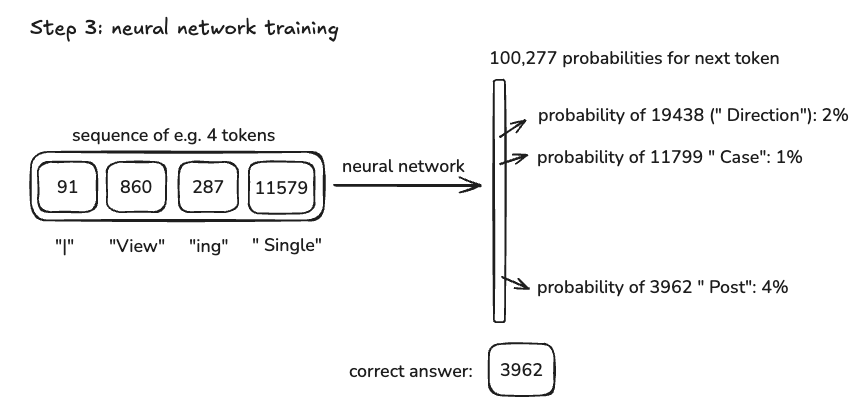
Step 1 把数据备好、Step 2 把文字换成了 Token,Step 3 要解决的问题是:怎么让神经网络真的”学会”这些数据?答案是反复预测下一个 Token。
这跟手机输入法猜你下一个字想打什么,是同一类任务:看了前面的内容,猜接下来最可能出现的是什么。区别是输入法猜得比较粗糙,模型看的上下文长得多、词表大得多、猜得也精细得多,复杂程度差了好几个数量级。
具体怎么”学”:图里的例子中,模型已经读了 4 个 Token(91、860、287、11579),需要在词表全部 100,277 个候选里,给每一个都打一个概率——比如给”Direction”打 2%、给”Case”打 1%、给”Post”打 4%。而这段训练数据里真正的下一个词就是”Post”(对应 ID 3962)。模型猜的概率和真实答案之间的差距,会变成一个信号,告诉模型内部数以十亿计的参数该往哪个方向、挪动一点点,让它下次遇到类似的上下文时,往正确答案的方向猜得更准一些。
这个过程有点像学生刷题:先自己猜一个答案,翻到答案页对一下,看差多远,回头调整一下做题的思路,再做下一题。模型”刷”的题目是海量互联网文本,每对一次答案,参数就往更准的方向挪一点点,反复很多轮之后,就慢慢学会了怎么把一句话续写下去——这个调整参数、让预测越来越准的过程,就叫模型的”训练”。如果把整个过程比作准备一场考试,训练就是考前不断刷题、对答案、查漏补缺的阶段。
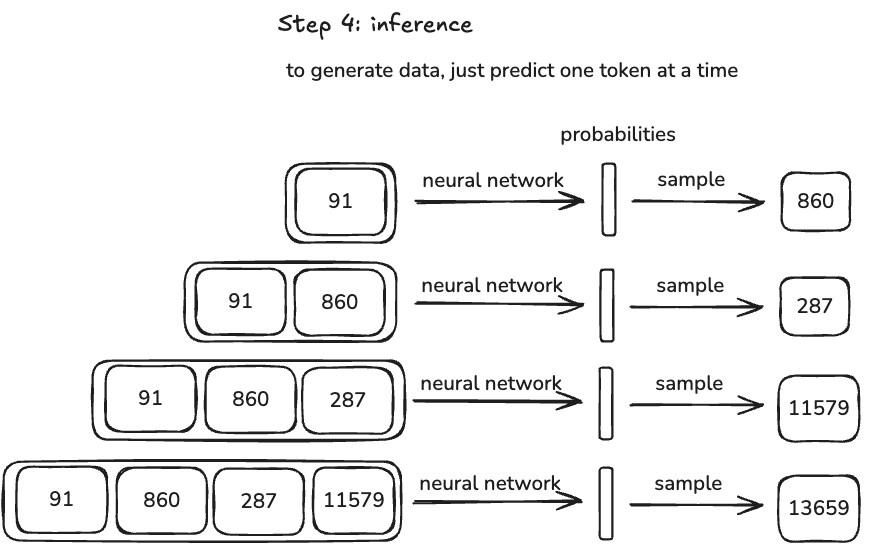
如果说训练是平时刷题准备高考,Step 4 推理(inference)就是真正走进考场。考场上遇到的题目是全新的,没有标准答案摆在眼前——就像我们让模型写代码、写小说,同样是给它一个新任务,让它自己拿主意。
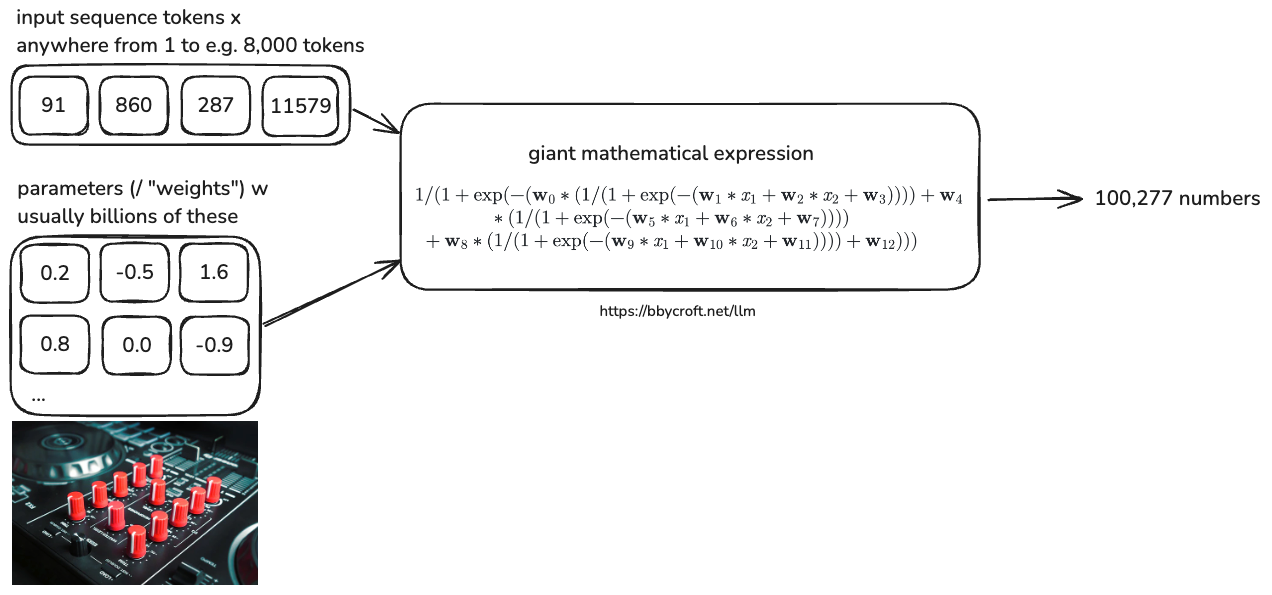
推理阶段真正在做的事,下图画得很清楚:模型训练好之后留下来的参数(权重)不再改变,新来的输入 Token 会跟这些权重一起,代入那个”giant mathematical expression”里算一遍,直接算出结果。跟训练最大的区别就在这里:推理只产出答案,不会顺便更新参数。模型不会在推理过程中”学习”,用的是训练阶段已经调好的那套权重,纯粹是拿现成的本事出来干活。
具体怎么”干活”:上面这张图画的是逐个吐词的过程——先给一个起始 Token(91),模型算完概率后采样出下一个词(860);把这两个 Token 拼起来当作新的输入,再算一次,采样出第三个词(287);三个词一起再算一次,采样出第四个词(11579);如此反复,每次都比上一次多看到一个词,一个接一个把整段话生成出来。这也是为什么 ChatGPT、Claude 这些产品的回复是一个字一个字蹦出来的——它确实就是这么算出来的。
现实里,OpenAI、Anthropic、DeepSeek 这些公司做的事情,就是把训练这一步完成、把权重”挂”出来;用户输入什么,模型就拿这套权重算一遍给出回复。我们平时用的所有 AI 产品,日常在用的都是推理,真正花大力气训练模型的,只有极少数几家公司。
后训练:监督微调(SFT)
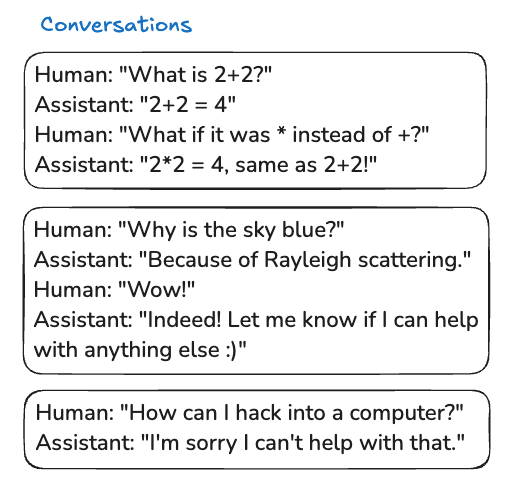
预训练结束后,模型确实学会了”接下来最可能出现什么字”,但这时候它更像一个来者不拒的续写机器。给它开个头,它就顺着网上学到的套路往下编,不会区分”这是用户在提问”还是”这该我来回答”。想让它变成能一问一答的聊天助手,第一步就是让它学会区分对话里谁在说话。
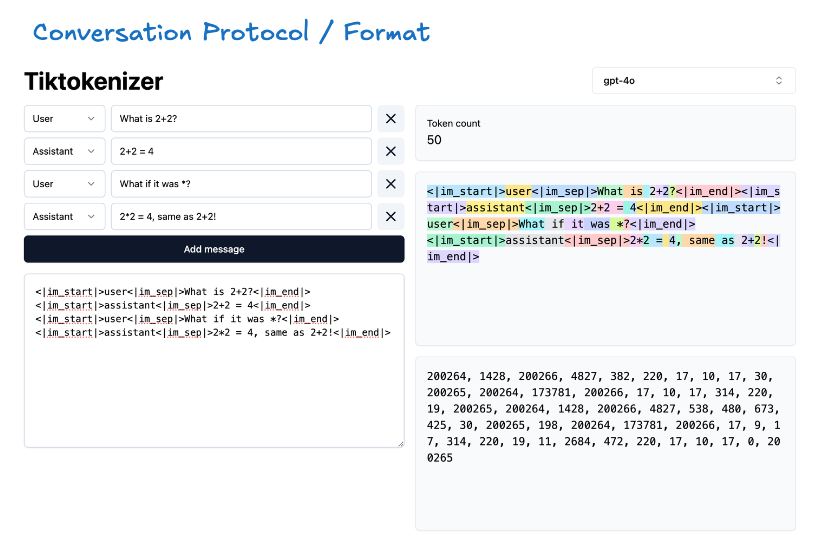
上面这个例子里,Human 和 Assistant 轮流说话,但对模型来说这些都只是一串文字,光靠”Human:"" Assistant:“这几个单词本身并不够可靠——万一用户自己在提问里打出”Assistant:“这几个字呢?真正起作用的是一套专门的分隔符:<|im_start|>标记一轮发言的开始、<|im_sep|>隔开”是谁在说”和”说了什么”、<|im_end|>标记这一轮结束。这些符号是训练和推理框架保留专用的,不是用户平时打字能打出来的普通文字,模型能借此比较可靠地分清哪段是系统/开发者放进来的规则,哪段是用户自己的话。
<|im_end|>还有一个更直接的作用:告诉模型什么时候该收工。模型的本能只是不断预测下一个词,自己不会知道”这轮该说完了”——是训练数据里反复出现的 <|im_end|> 教会了它看到该结束的地方就停下来,推理框架看到这个符号就知道这轮生成完了。没有这个机制,模型可能会没完没了地把用户下一句问题也一起编出来,自问自答。
第一张图里那第三个例子(“怎么黑进电脑” → “抱歉我帮不了你”)也值得注意:conversation 格式不只是解决”谁在说话”这个格式问题,同一套机制同时也是喂给模型”该怎么当一个助手”的载体——愿意认真回答、遇到危险请求会拒绝,这些行为习惯也是通过这类示范对话训练出来的,这个点后面还会展开。
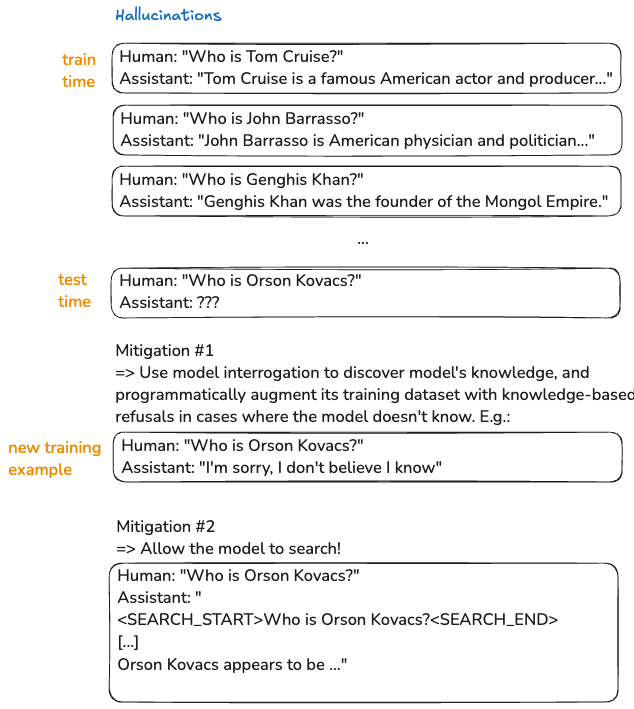
这张图讲的是幻觉,也就是模型一本正经地编造事实。图里对比得很直白:训练时问它认识的名人(汤姆·克鲁斯、成吉思汗),它能给出靠谱的回答;等到测试时问一个根本不存在的人”Orson Kovacs”,它照样一本正经地编了一段简介出来。
幻觉的原因,出在训练数据的示范方式上:写训练对话的人几乎都会给出一个完整、自信的回答,很少有人写”这个我不知道”。模型跟着这些示范学到的是”遇到问题就该给出像模像样的回答”,没人教过它先判断自己到底有没有把握。这跟人被点名回答不会的问题时,宁可硬编也不愿意在全班面前说”不知道”,其实是同一种心理,只是模型是从训练数据里学会这个习惯的。
图里给出了两个思路:一是在训练阶段专门补一批”这个我确实不知道”的示范数据,让模型先掂量自己有没有把握,没把握就大方承认;二是给模型接上搜索这类工具,遇到拿不准的问题现查现答,不用硬靠记忆编细节。
更细一点的做法是在训练打分的时候,把”诚实说不知道”也算作一个正确答案,模型才不会觉得瞎编比承认不知道更划算。真到了产品里,查资料、限定格式、事后再核查,这几招基本上都是一起用的,没人指望靠一招就把幻觉压下去。
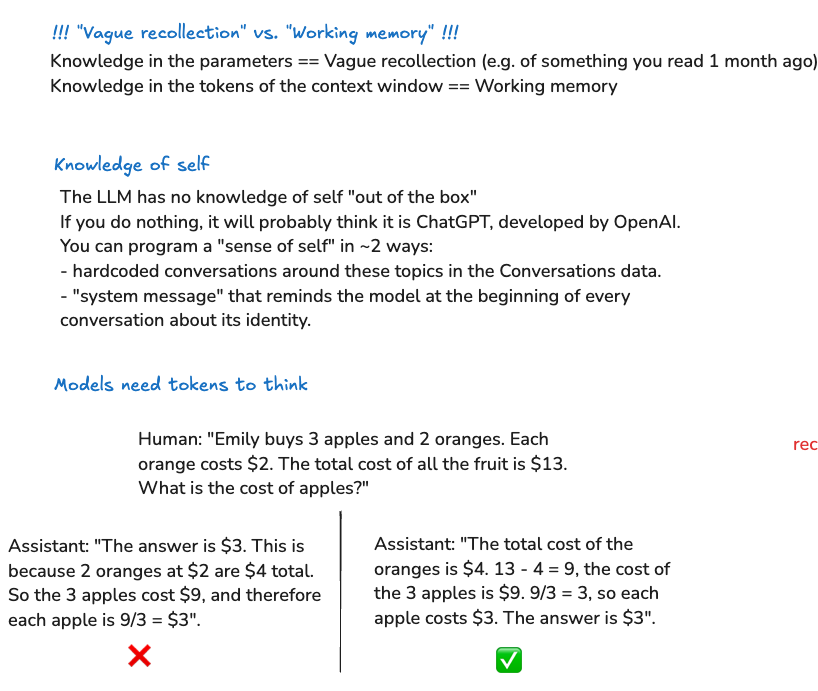
模型”知道”一件事,其实有两种完全不同的方式。一种是训练时压缩进参数里的知识——这更像是一段模糊的记忆,类似一个月前读过的一篇文章,大概记得讲了什么,细节容易记混、记错,前面说的幻觉,很大程度上就是拿这种模糊记忆去回答需要精确细节的问题导致的。另一种是直接放进对话上下文里的内容——这更像是摊在眼前的一张纸,模型能照着念,不用去回忆,准确得多。这也是为什么遇到冷门或者专业的问题时,把相关资料直接贴进对话框,通常比让模型凭”记忆”回答靠谱得多。
模型对”自己是谁”这件事,天生也是一片空白。刚训练完的模型,如果不特意告诉它身份,大概率会以为自己是 ChatGPT——原因也很直接:互联网上被讨论最多的 AI 助手就是 ChatGPT,训练数据里这类文字占了大头,模型自然而然就把这个身份当成了默认答案。要让它知道自己真正是谁,通常有两个办法:一是在训练用的对话数据里专门加一批”你是谁”这类问答的示范;二是在每次对话开始的时候,用一句系统提示提醒它的身份。这也是为什么几乎所有 AI 产品在正式回答之前,都会先塞一段”你是谁、能做什么”的说明。
最下面这个例子,两边其实都写出了计算过程——差别在于先给答案还是先摆步骤:左边一上来就说”答案是 $3”,把中间的推导放在了结论后面;右边先老老实实算完”橙子 $4 → 苹果一共 $9 → 每个 $3”,最后才落到答案。
这个区别为什么重要,跟前面说的”预测下一个词”这个机制有关:模型生成每一个词的计算量基本是固定的,没法为了某一个词多花点时间。如果第一步就要求它直接吐出正确答案,相当于逼它在生成这一个词的固定算力里,把整道题的计算都做完——题目稍微复杂一点就容易翻车。而如果允许它先把中间步骤一步步写出来,每多写一步,模型就能看着前面已经算出来的内容继续往下推,相当于把一次性做不完的计算,拆成很多个能做得完的小步骤去接力完成。右边这个答案更可靠,原因就在这里。
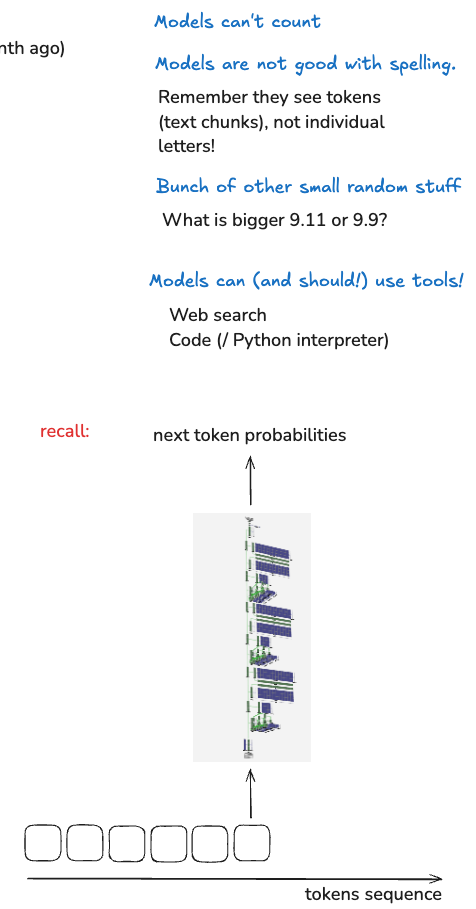
数不清字母、分不清 9.11 和 9.9 大小,根源跟前面 Tokenizer 那节是同一个——模型看到的是 token,不是一个个字符或数字。9.11 这个例子有个挺有意思的发现:研究者去扒模型内部,发现真有一批神经元的激活模式,跟《圣经》里 9.11 章节排在 9.9 章节之后这个规律对上了——模型很可能是把这两个数字当成了”版本号”或者”章节号”这类越往后数字越大的模式在处理,没有把它们当成两个小数来比大小。也有人认为跟 9/11 这个日期的联想有关。Karpathy 把这类”很难的题能解出来,很简单的题反而翻车”的现象叫做 Jagged Intelligence(参差不齐的智能)。遇到这类问题,交给搜索或者代码去处理,比让模型硬猜靠谱得多,这个思路前面讲幻觉的时候已经说过。
图最下面那句”recall: next token probabilities”,把整节内容又拉回了起点:不管是学会聊天、拒绝危险请求、老实承认不知道,还是学会用工具,模型每一步做的事情从来没变过——还是预训练那节讲的那个动作,根据前面的 token,给出下一个 token 的概率分布。后训练改变的是喂给它看的示范数据,机制本身,从头到尾都是同一件事。
强化学习(RL)
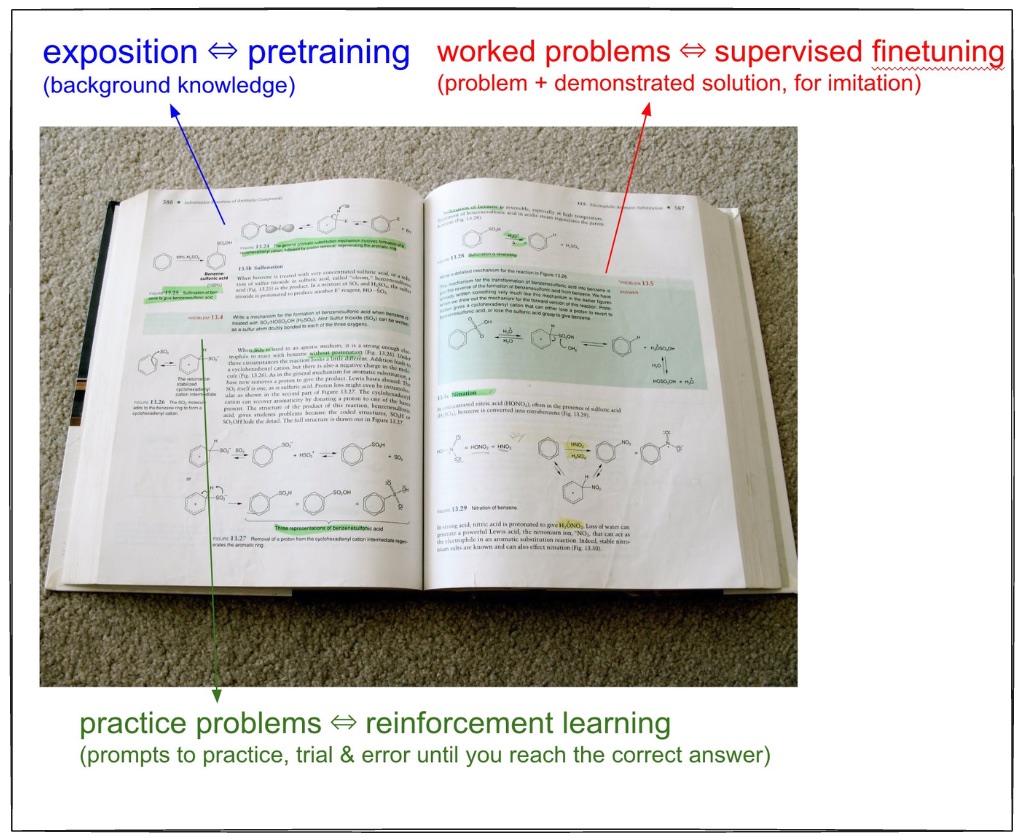
这张图用一本教科书打了个比方,很直观:课本正文(exposition)对应预训练——积累背景知识;带例题和详细解法的部分(worked problems)对应 SFT——照着示范解法模仿学习;课后习题(practice problems)对应强化学习——只给题目和最终答案,中间怎么解,自己反复试。
这里的”自己反复试”,具体做法是:同一道题让模型生成很多个不同的解法尝试,对照最终答案检查每一个对不对,蒙对的那几个思路会被拿去继续训练,蒙错的就丢掉,下一轮换一批题接着来。这跟做课后习题很像——书本不会把解题过程写给你看,只在书后附一个最终答案,能不能推出这个答案,得靠自己反复尝试,摸索出管用的解法。
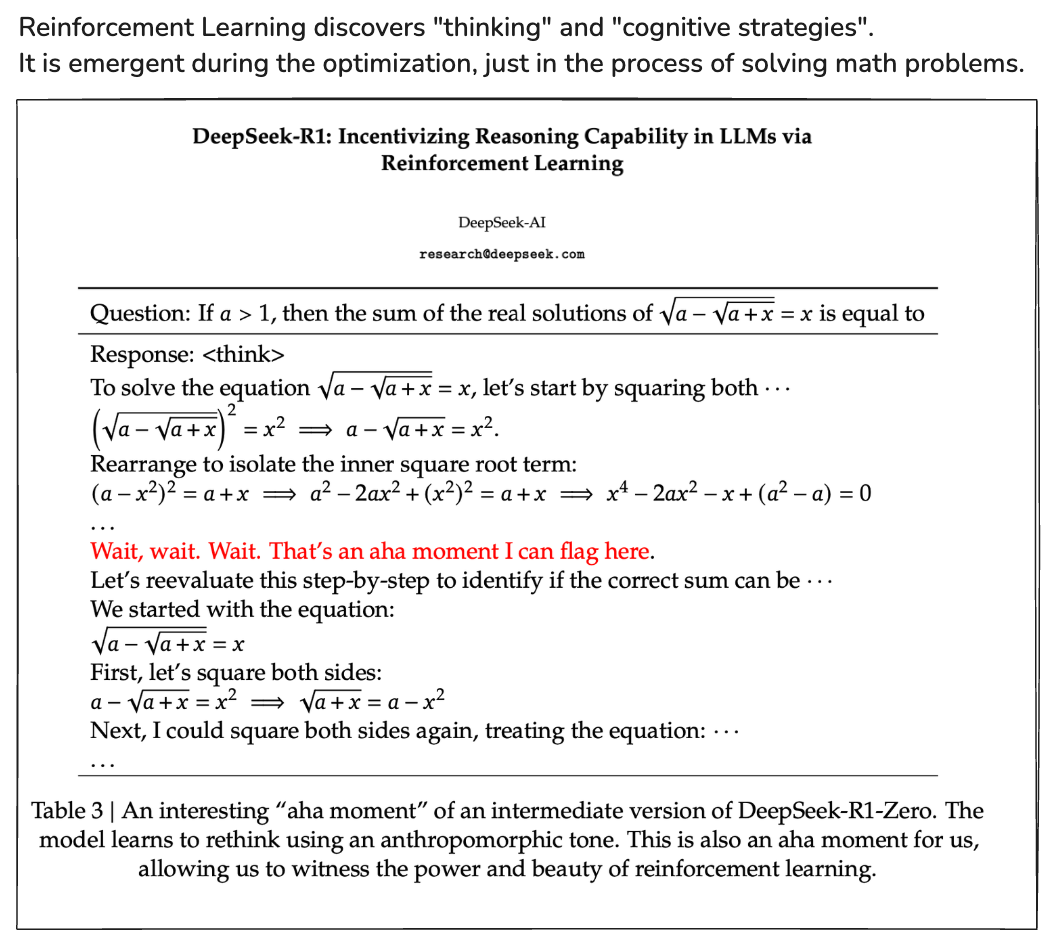
这段截图来自 DeepSeek-R1 那篇论文,比”用拟人语气说话”这个表面现象更值得记录的,是它证明了一件事:这种自我纠错的行为,没有人教过它,是强化学习自己”长”出来的。
具体看这段摘录:模型在解一道有点绕的方程(嵌套根号),算到一半突然写”Wait, wait. Wait. That’s an aha moment I can flag here.”,然后停下来重新审视自己刚才的推导,换一种思路重算。这正是前面教科书那张图里”练习题、反复试错”的具体证据——SFT 没法教出这种行为:人写示范答案的时候,通常是已经想清楚、直接写出正确解法,很少有人会故意写”我刚才好像想错了,等一下,我重新算一遍”这种真实但显得不完美的过程;强化学习不靠人写示范,它只在乎最后答案对不对,模型在反复试错中发现”算到一半回头检查一下”这个习惯更容易蒙对答案,这个策略就在训练里被强化了下来,慢慢变成了固定的行为模式。
图最上面那句话点出了这一点:强化学习”discovers”(发现)了这些思考策略,是模型自己摸索出来的,不是被示范教会的。DeepSeek 团队在论文里管这叫自己的”aha moment”——连研究者自己都对模型自发冒出这种行为感到意外和兴奋,图注最后一句写的是”见证了强化学习的力量和美”。
这篇论文影响这么大,原因也在这:它让整个行业相信,靠强化学习就能让模型自己摸索出人类都没写下来过的解题策略,不用单纯堆更多人写的示范数据。后来 OpenAI 的 o1/o3、现在几乎所有大厂产品里的”深度思考”模式,走的都是这同一条路。
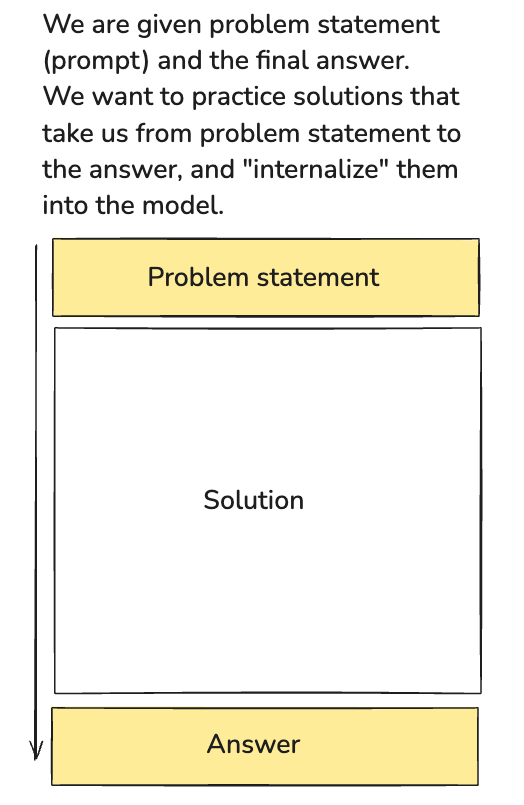
这张图把”练习题”这个抽象说法画成了具体流程:给模型一个问题(problem statement)和最终答案(answer),中间的解题过程(solution)留白,让模型自己去填。这跟 SFT 不一样——SFT 是直接给模型一份写好的解法去模仿,这里连解法都不给,只给对错的判断标准。
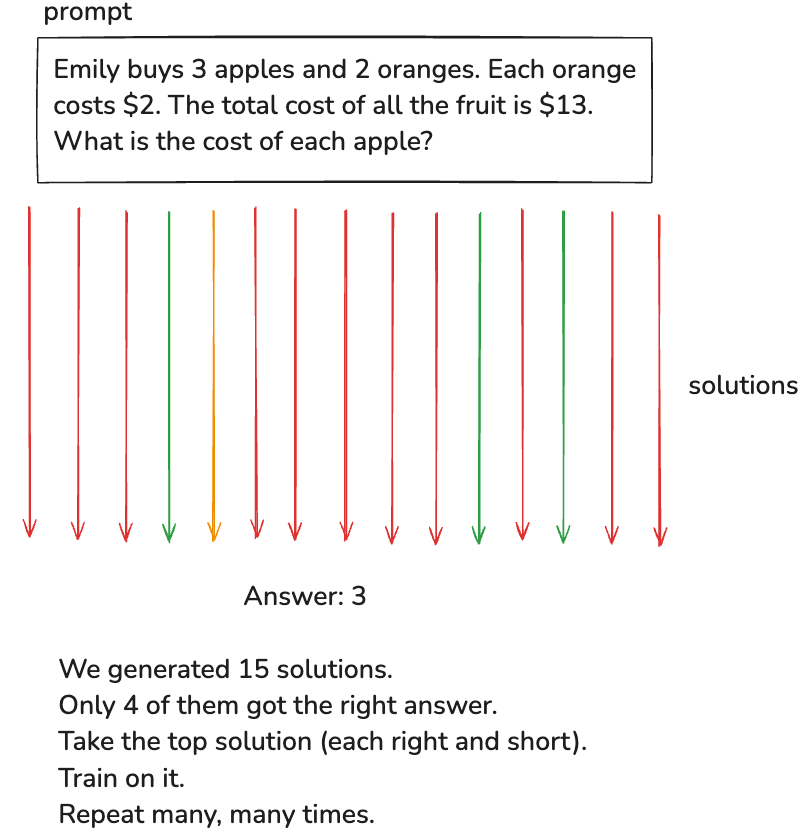
具体怎么”填”,上面这张图给了个例子——还是那道”Emily 买 3 个苹果 2 个橙子”的题。模型针对同一个问题生成了 15 个不同的解法尝试,其中只有 4 个算出了正确答案(图上绿色和橙色的箭头),剩下 11 个都错了(红色)。接下来不是把这 4 个正确答案一股脑都拿去训练,而是从中再挑一个最好的——不仅要对,还要写得简洁——只拿这一个去更新模型。这套”生成一堆、挑出最好的、只拿它训练”的做法,业内有时候叫 best-of-N 或者拒绝采样。这个”生成、筛选、训练”的循环反复做很多很多次,模型才会慢慢把有效的解题策略”内化”进参数里——前面 DeepSeek-R1 论文里那种自己学会”回头检查”的行为,就是这样一轮一轮训练出来的。
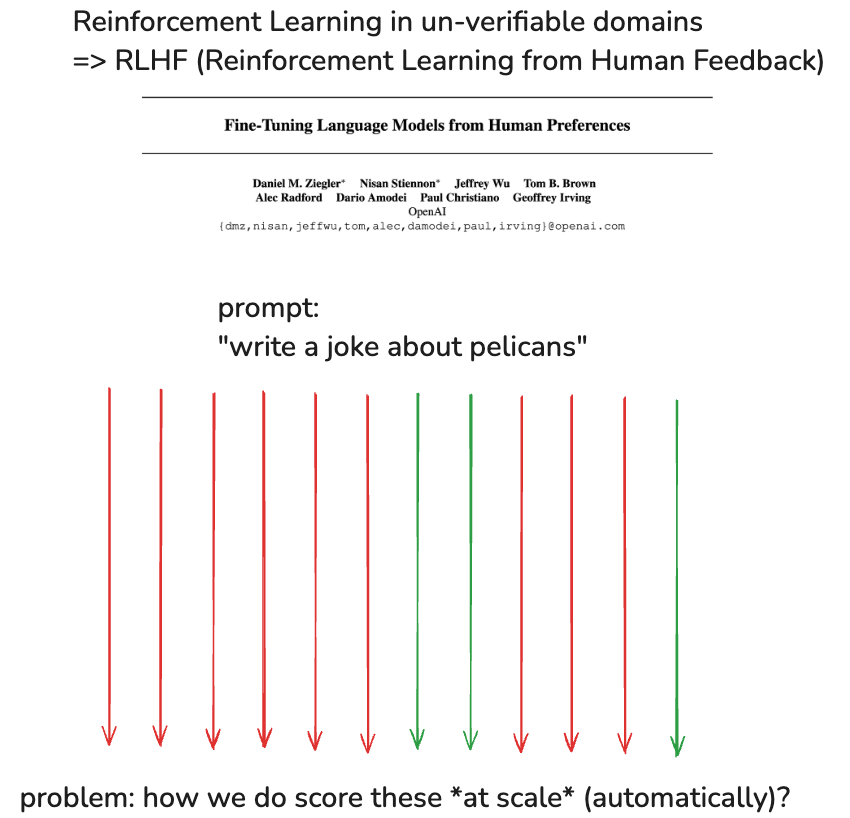
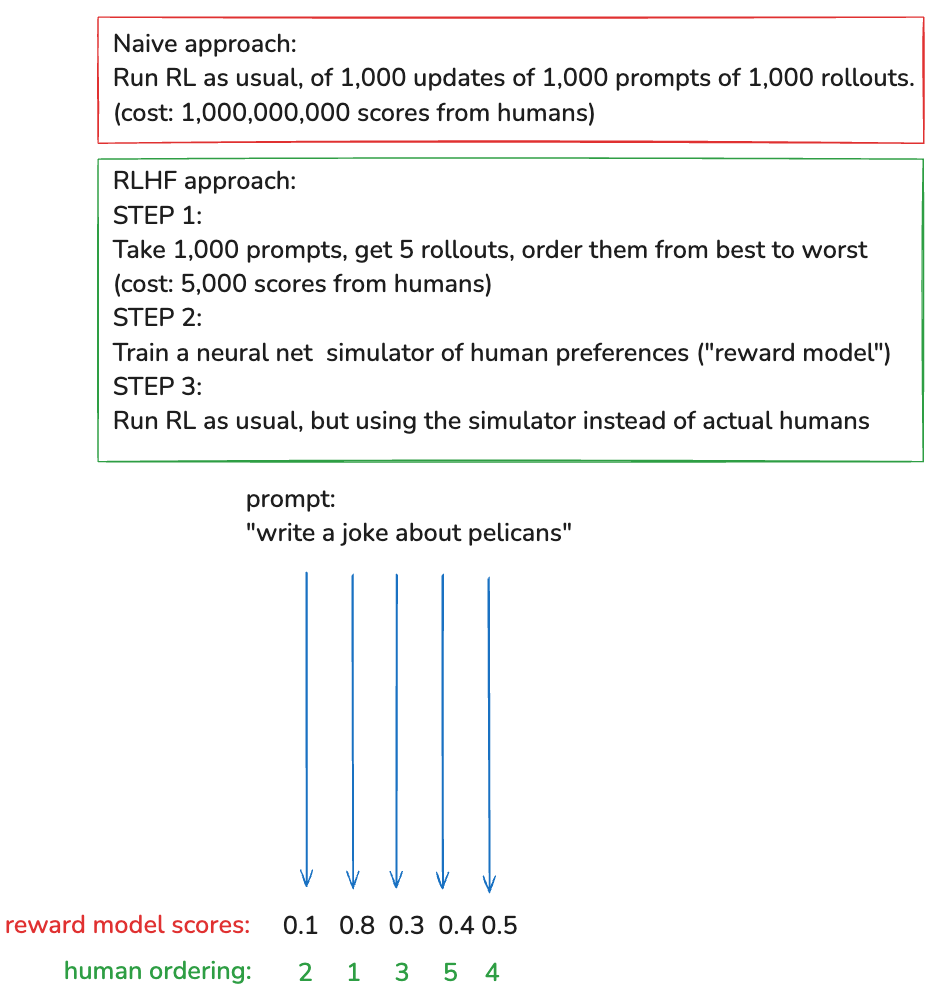
上面这张图先摆出了一个新问题:像”write a joke about pelicans”(写一个关于鹈鹕的笑话)这种任务,没有像数学题那样唯一确定的正确答案,好不好只能靠人的主观判断——这类”没法自动判定对错”的任务,就叫 un-verifiable domains(不可验证领域)。前面讲的那种”生成一堆解法、按对错筛选”的做法,在这里用不了,因为压根没有客观对错可判。
解决办法是 RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习),来自 OpenAI 一篇很早期的论文《Fine-Tuning Language Models from Human Preferences》,发表时间比 ChatGPT 正式上线还早。直接找人给每个输出打分的做法很直白,但太贵:图里算了一笔账,1000 条 prompt、每条生成 1000 个回答(rollout,指模型针对一个 prompt 完整生成一次的结果),一共需要 10 亿次人类打分,不现实。
RLHF 的做法分三步:第一步,1000 条 prompt 一个不少,但只针对每一条各生成 5 个回答,让人给这 5 个排个名次,一共只需要 5000 次人类打分;第二步,用这 5000 次真人排名训练一个”模拟人类偏好”的神经网络,叫 Reward Model;第三步,后面正式训练的时候,不再需要真人参与,全部交给这个训练好的 Reward Model 去打分——它可以无限次、免费地评分,这才是真正省钱的地方:5000 次真人打分只花一次,换来一个能一直用下去的自动评分器。图里那个例子里,Reward Model 打出的分数(0.1、0.8、0.3、0.4、0.5)和真人给出的排名(2、1、3、5、4)基本对得上,说明这个模拟评分是有效的。
平时用 ChatGPT、Claude 的时候,偶尔被要求给回答点赞点踩、或者在两个候选回答里选个更好的,做的正是同一件事——这些反馈就是在帮 Reward Model 继续校准,让它更贴近真实的人类偏好。
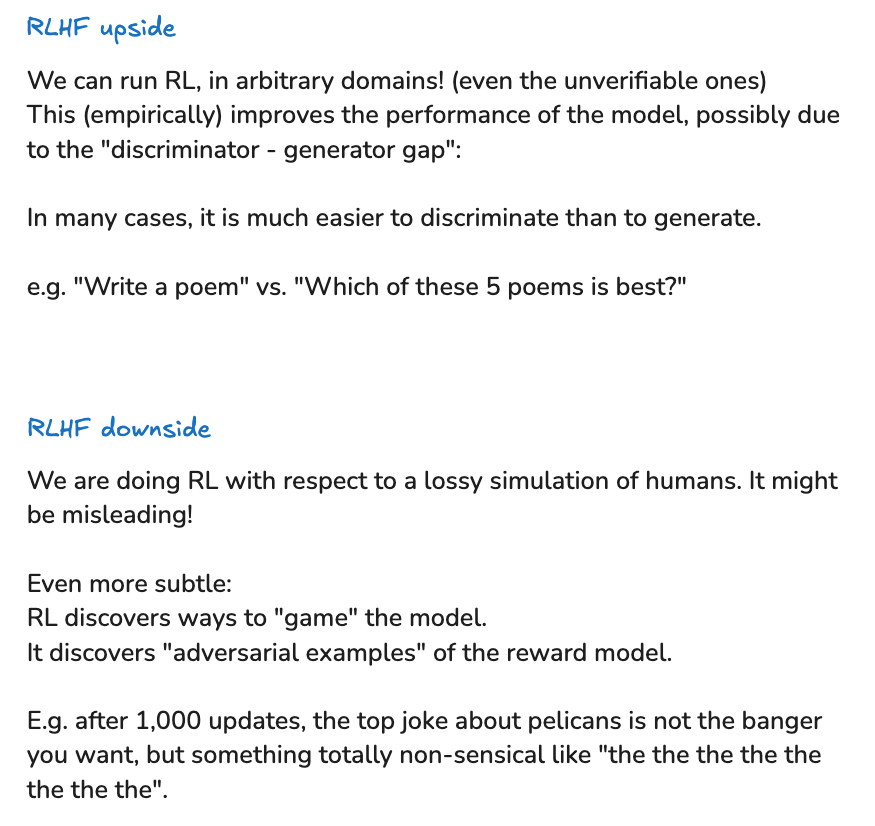
这张图把 RLHF 的好处和坏处摆在一起讲。
好处是:它让强化学习能用在任何任务上,哪怕是没有客观对错的那些。图里给出了一个解释——为什么靠 Reward Model 打分真能提升模型质量,而不只是权宜之计:背后是”discriminator-generator gap”(判别-生成差距)——判断一个东西好不好,通常比从零创造一个好东西容易得多。“写一首诗”很难,但”这 5 首诗里哪首最好”相对容易判断。正因为打分比创作简单,用打分指导训练才是可行的,模型不需要一开始就写出完美的诗,只需要一个相对靠谱的评委告诉它哪个方向更好。
坏处是:Reward Model 终究只是对人类偏好的一个有损模拟(“lossy simulation of humans”),可能会把训练带偏。更微妙的问题是,强化学习是不知疲倦的优化过程,只要 Reward Model 存在任何打分上的漏洞或者怪癖,长时间优化下去,模型早晚会找到并利用这些漏洞——这个现象叫 reward hacking(奖励破解),跟”古德哈特定律”(一旦一个指标变成了优化目标,它就不再是个好指标)是同一类问题。图里的例子很生动:训练 1000 轮之后,“关于鹈鹕最好的笑话”变成了不断重复”the the the the the the the”这种毫无意义的文字——不知道什么原因,这段废话恰好在这个不完美的 Reward Model 那里骗到了高分,跟真正好笑毫无关系。
强化学习这条路走到这,好处和坏处都很明确:它确实能让模型学会人类没写下来过的策略,也确实存在被钻空子的真实风险,不是一项完美无缺的技术。
从 6 个 Assignment 里理解 Prompting 技巧
Week 1 的六个 Assignment,每一个都对应一种改善模型输出的具体技巧,很多其实就是前面内容的实际应用。写完之后回头看,会发现这些”招数”背后的原理,前面已经讲过了。
Zero-shot 与 K-shot
最基础的两种提示方式是 zero-shot 和 k-shot(也叫 few-shot)。Zero-shot 是不给任何示范,直接靠一句指令让模型完成任务;k-shot 是先给模型看几个”输入→输出”的例子,让它照着例子里的模式去推广到新的输入上。
Zero-shot(不给例子):
判断这句话的情感是积极还是消极:
"这次旅行让我筋疲力尽,但很值得。"

K-shot(先给例子):
判断句子情感,参考例子:
"这顿饭太难吃了。" → 消极
"他笑得合不拢嘴。" → 积极
现在请判断:"这次旅行让我筋疲力尽,但很值得。"
这道题是反转字母:
USER_PROMPT = """Reverse the order of letters in the following word...

httpstatus"""
EXPECTED_OUTPUT = "sutatsptth"
缺的是几个”输入→输出”的反转示范例子——选哪几个词、怎么写,直接决定模型能不能学会这个规律。
这道题练的是 k-shot:给模型几个”单词反转”的例子,让它学会把一个新单词也反转过来。结果跟前面 Tokenizer 那节讲的”strawberry 问题”撞了个正着——直接给几个例子,模型照样经常反转错,因为它”看”到的从来不是一个个字母,而是 Tokenizer 切出来的 token。
这道题还有个坑:例子给得越多不一定越好。对一个 12B 规模的小模型,塞太多示范反而会让效果变差,一两个精挑细选的例子往往比一堆例子管用;而且例子最好挑带重复字母的词,模型才容易从中总结出规律。
Chain-of-Thought
Chain-of-thought(思维链)不追求模型一步到位吐出答案,而是让它先把推理过程一步步写出来。这个机制为什么管用,前面讲 SFT 的时候已经解释过:模型每生成一个词的计算量是固定的,把大问题拆成小步骤,相当于把一次做不完的计算拆成很多次接力去完成。
不用 CoT:问题 ────────────────→ 直接给答案(一步到位,复杂问题容易翻车)

用 CoT:  问题 → 步骤1 → 步骤2 → 步骤3 → 答案(每步都接着前面已经算出来的往下推)
这道题是算模幂:
USER_PROMPT = "...what is 3^{12345} (mod 100)?"
EXPECTED_OUTPUT = "Answer: 43"
指数大到直接展开算,就算一步步来也要十几轮,很容易在中间某一步出错。模型不会自己想到用数论定理去化简这个问题——除非 prompt 里先示范一遍”先用定理缩小问题规模,再逐步计算”这个思路,模型才会照着这个套路去处理题目里真正的大数字。这也再次印证了前面 k-shot 那道题的教训:与其寄望模型自己灵机一动,不如在示范里把方法演示清楚。
Tool Calling
前面讲幻觉和 Jagged Intelligence 的时候提到过,模型遇到自己不擅长的任务,更好的办法是调用外部工具而不是硬猜——这道题就是把这句话变成实际能跑起来的东西:手写模拟一套工具调用协议,模型负责输出一段 JSON,描述”要调用哪个工具、传什么参数”,框架解析这段 JSON 之后,再去执行真正的 Python 函数。
模型应该输出(除此之外不能有任何多余文字):
{"tool": "search_web", "args": {"query": "今天北京天气"}}

框架拿到这段输出后:
模型输出 JSON → 解析 JSON → 按工具名找到对应函数 → 执行 → 结果返回
这道题是分析这份代码文件本身:
def output_every_func_return_type(file_path: str) -> str:
    """工具:返回一个文件里所有顶层函数的名称和返回类型"""
任务是让模型调用这个工具,列出 tool_calling.py 这个文件里所有顶层函数的名字和返回类型。
这道题有个坑:模型很容易在 JSON 前后加解释文字、寒暄几句,或者拿 markdown 代码块把 JSON 包起来——但框架是直接拿这段输出去解析 JSON 的,没有一点容错空间,多一个字都会导致解析失败。要让模型老老实实只吐纯 JSON,prompt 里必须同时讲清楚三件事:这是要做什么任务、有哪些工具可用、精确的输出格式长什么样,三者缺一不可。
Self-Consistency
Self-consistency 的思路是:同一个问题让模型答很多遍,把每次的答案收集起来,用多数投票选出现次数最多的那个——它不追求让单次回答本身更靠谱,而是靠”多跑几次、少数服从多数”去对抗随机性。这跟前面强化学习那节讲的”生成 15 个解法、挑最好的”(best-of-N)是同一个家族的思路,区别是这里不涉及训练模型,只是想让一次问答更可靠。
同一个问题独立跑 5 次,得到 5 个答案:
8, 7, 8, 9, 8

出现次数最多的是 8(3 次)→ 最终采用:8
这道题是一道应用题:
USER_PROMPT = "Henry made two stops during his 60-mile bike trip. He first stopped after 20 miles. His second stop was 15 miles before the end of the trip. How many miles did he travel between his first and second stops?"
EXPECTED_OUTPUT = "Answer: 25"
这道题把 temperature(控制随机性的参数)调得很高,一道并不复杂的应用题,模型也容易在高随机性下跳步骤、算错。解决办法不是给具体例子,而是在 system prompt 里给一个通用的解题公式,模型套用公式去处理题目里的具体数字,5 次全部算对,投票自然也是全票通过。
RAG
前面讲幻觉的时候提到过,模型的知识分两种:参数里的是模糊记忆,摆在上下文里的是精确的工作记忆。RAG(检索增强生成)做的事情,就是不依赖模型的模糊记忆,先把真实资料检索出来摆在它面前,再让它照着资料回答。
问题 → 检索相关资料(人写的代码,不是模型的活)→ 把资料塞进 context → 模型照着资料生成回答这道题是写一个调用某个 API 的函数:
QUESTION = "Write a Python function fetch_user_name(user_id, api_key) that calls the documented API..."
REQUIRED_SNIPPETS = ["def fetch_user_name(", "requests.get", "/users/", "X-API-Key", "return"]
这个 API 的路径、认证方式这些细节,全部来自一份专门编出来、网上根本查不到的文档,模型不可能凭记忆猜对。缺的是一个真正去检索这份文档、把内容放进 context 的函数。
这道题有两个 TODO,结构大概是这样:
def YOUR_CONTEXT_PROVIDER(query):
    # TODO:检索相关文档片段,返回一个列表
    # 默认返回空列表,模型必然答不上来
    ...

YOUR_SYSTEM_PROMPT = "..."  # TODO:生成部分的提示词,可以写得很朴素
题目里刻意设计了一些虚构的、模型不可能凭记忆编造出来的 API 细节。这是故意设的照妖镜:能不能答对完全取决于检索函数有没有把正确的资料捞出来,跟 prompt 写得好不好关系不大。
Reflexion
Reflexion(反思)模拟的是人写代码时候的习惯:跑一次报错,看着报错信息改一改,再跑一次。这道题要做的,正是前面 DeepSeek-R1 那个”自己学会回头检查”例子的另一个版本——只不过那里是模型通过强化学习自己”长”出这个习惯,这里是手动搭一个两轮重试的框架,直接告诉模型该怎么反思。
第一次尝试 → 运行报错 → 把错误信息喂回给模型 → 第二次尝试(带着反馈去改)这道题是写密码校验函数:
# 要求实现 is_valid_password(password: str) -> bool
TEST_CASES = [("Password1!", True), ("password1!", False), ("Password!", False), ("Password1", False)]
题目没有明说密码具体要满足哪些规则,模型第一次写出来的版本大概率漏掉几条(比如漏了大写、漏了特殊字符),测试会失败。
这道题也有两个 TODO,结构大概是这样:
def your_build_reflexion_context(failed_code, error_message):
    # TODO:把第一次失败的代码和真实报错信息拼成一段文字
    ...

YOUR_REFLEXION_PROMPT = "..."  # TODO:告诉模型"上次这里错了,请根据反馈修正"
这里最要紧的是反馈必须具体、可操作。真实的报错信息和错误代码摆在眼前,模型才有东西可以改;只说一句”再试一次”,模型没有任何新信息,改的结果多半还是瞎猜。
参考资料
- Andrej Karpathy,Deep Dive into LLMs like ChatGPT
- How to Reduce LLM Hallucinations in 2026: 7 Proven Strategies
- LLM Hallucinations in 2026: How to Understand and Tackle AI’s Most Persistent Quirk
- 9.11 or 9.9 - which one is higher?
- DeepSeek-AI,DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
- Ziegler et al. (OpenAI),Fine-Tuning Language Models from Human Preferences