Week 1 讲的是 LLM 本身怎么”长成”的,Week 2 往上一层,讲 Agent 怎么拿到 LLM 训练时不具备的能力。这周的关键词是 Model Context Protocol(MCP)。
MCP 要解决什么问题
一个训练好的模型,能力是定死的:读文件、连数据库、操作浏览器,它都不会,只会根据前面的文字猜下一个词。想让它干这些事,得有人搭一座桥,把外部世界的能力接进对话里。
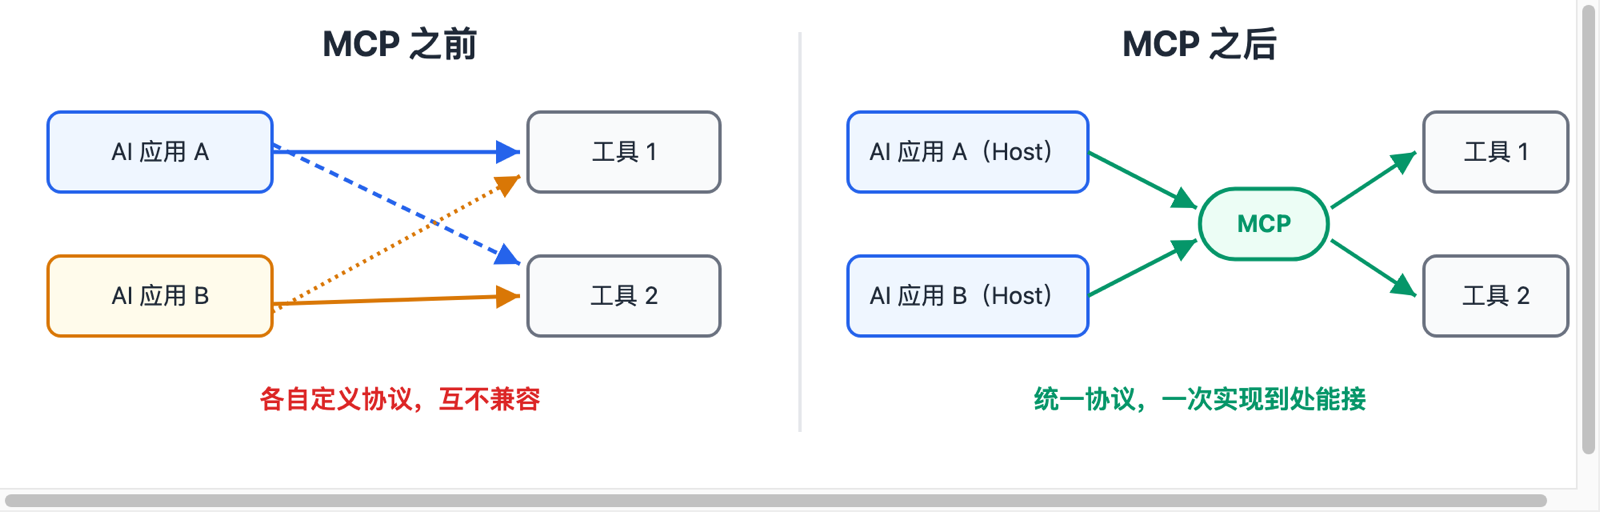
MCP 出现之前,这座桥基本是各家自己搭:OpenAI 的 function calling、各种 Agent 框架自己定义的工具协议,互不兼容,给 ChatGPT 写的工具搬到 Claude 里就要重写一遍。MCP 想做的事情很直接:定义一套统一协议,让”提供能力的一方”(Server)和”使用能力的一方”(Host,也就是 AI 应用)不用为了对接彼此各写一套适配代码。官方给的比喻是 USB-C——统一接口,一次实现,到处能接。
Host、Client、Server 是三个角色
这三个词里最容易搞混的是 Host 和 Client,两者常被当成同一个东西的两种叫法。
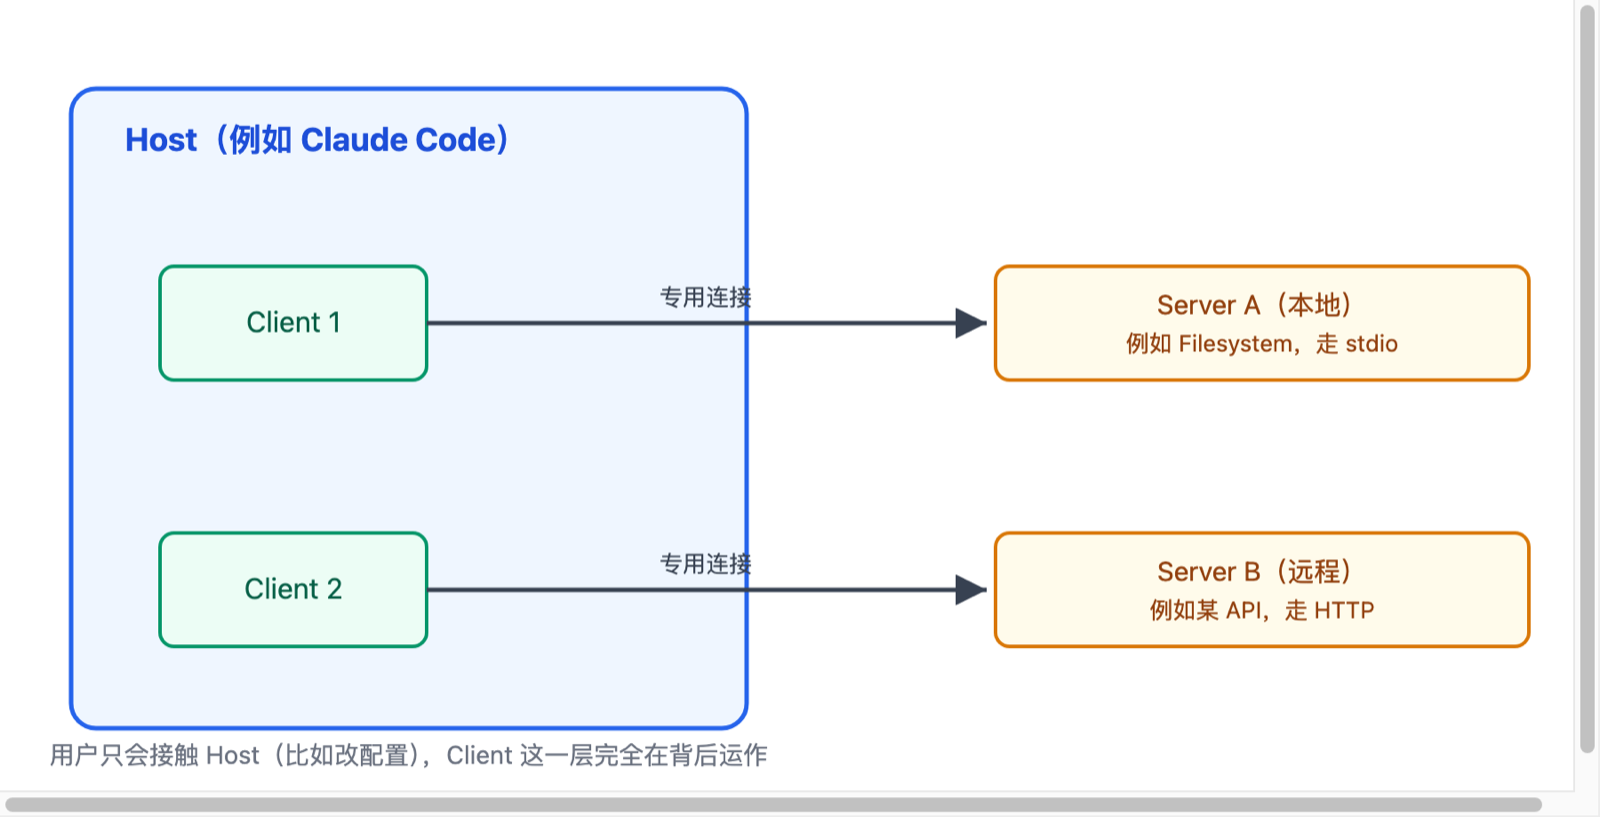
- Host 是完整的 AI 应用,比如 Claude Code、Codex、Claude Desktop——这是用户唯一能感知到的东西。
- Client 是 Host 内部的一个组件,每连一个 Server 就建一个 Client,专门维护和这一个 Server 的连接。如果 Claude Code 同时连了 filesystem、git 两个 MCP Server,内部就有两个 Client 实例,各管各的连接。
用户不会直接接触”Client”这一层。打开 Claude Code、在配置里加一个 MCP Server,剩下的事(创建 Client、维护连接、发请求)全是 Host 在背后做的。这也是为什么容易把 Host 和 Client 当成一回事:普通使用者根本看不到 Client。
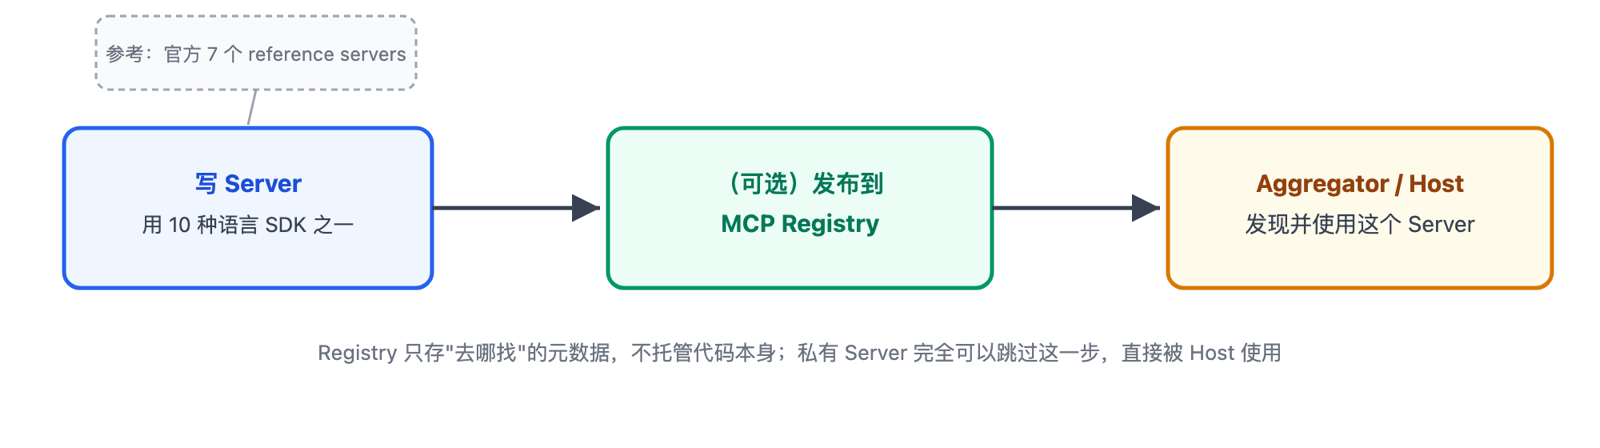
Server 是能力的提供方,一个跑在本地或远程的程序,照着 MCP 协议把自己的能力暴露出来。很多人以为 Server 得先在 MCP Registry 里注册才能被使用,其实不用。Registry 只是一个可选的公开黄页,方便别人发现已经存在的公开 Server;自己写一个 MCP Server,直接在配置里填启动命令就能用,从头到尾不用碰 Registry。它跟 npm、PyPI 存的东西也不一样:Registry 里只有元数据(这个 Server 叫什么、去哪个包管理器能下载到它),真正的代码还是放在 npm/PyPI/Docker Hub 这些地方。
Server 能给的三样东西:Tools、Resources、Prompts
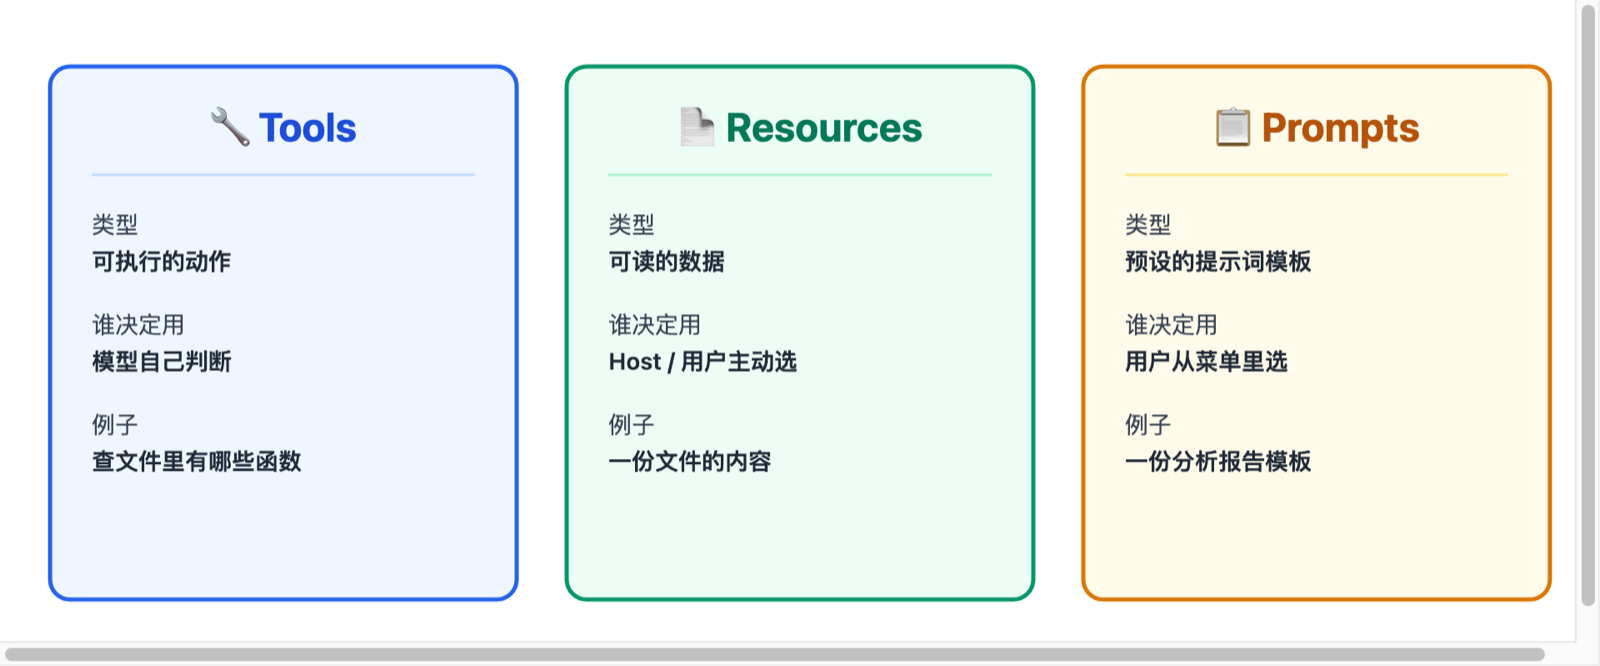
Server 暴露能力的方式被拆成了三种,而不是笼统的一个”工具”:
- Tools:能执行的动作,模型在对话过程中自己决定要不要调用,比如”查一下这个文件里有什么函数”。
- Resources:能读的数据,不涉及执行,更像一份可以被引用的文件或记录。
- Prompts:预先写好的提示词模板,通常是给人挑选用的,不是模型自己找的。
拆成三种的原因,是这三者在”谁来决定用不用”这件事上完全不同:Tool 是模型自己拿主意,看到任务判断需要调用哪个;Resource 更多时候由 Host 应用或用户主动选择要不要放进对话,类似聊天框里手动加一个附件;Prompt 则通常展示给用户挑,是一个模板菜单,用户选中之后再交给模型执行。如果把这三种都硬塞进”Tool”一种类型,Host 应用就没法区分”这该由模型自己判断”还是”这该展示给用户手动选”,交互设计会被迫退化成同一种模式。
两个被弃用的能力,和背后的取舍
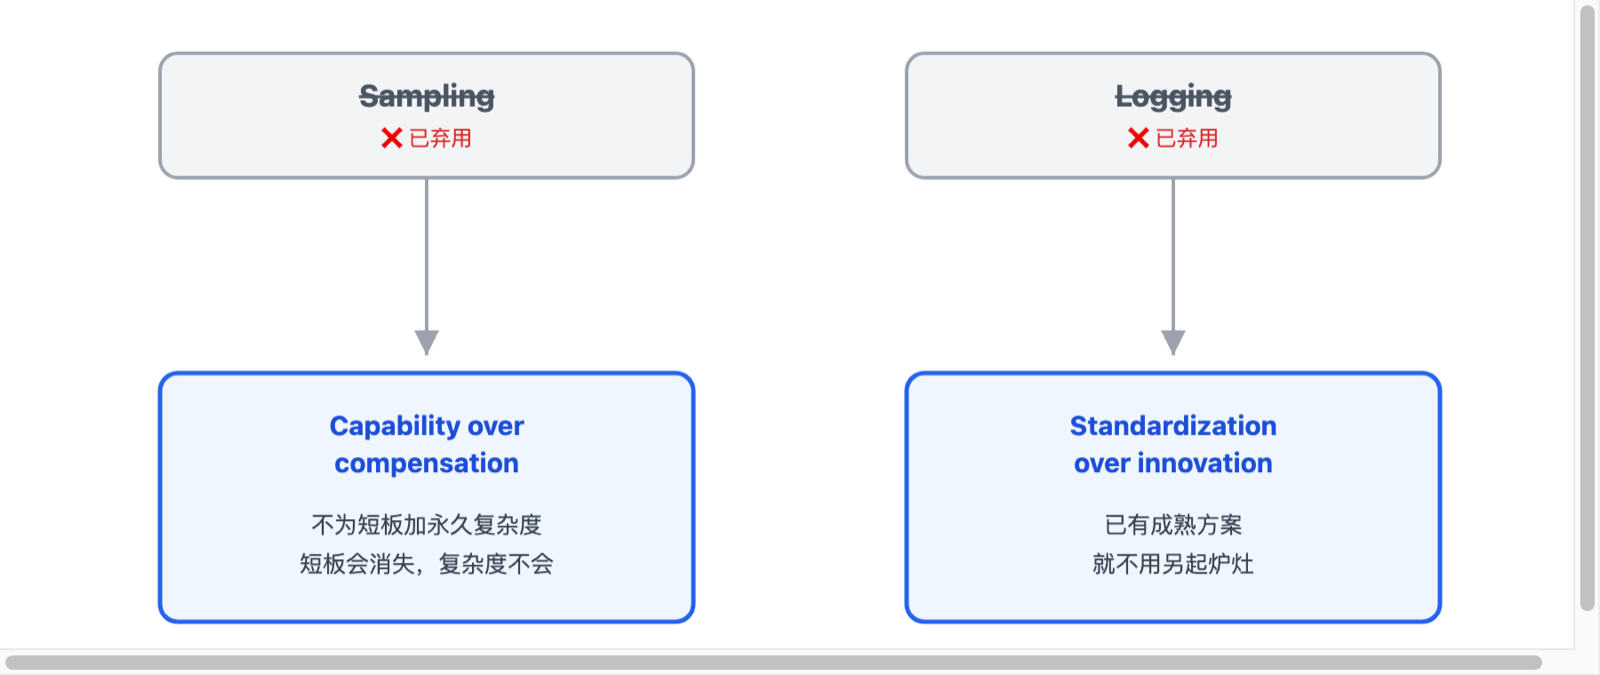
MCP 也给 Client 定义了几种能力,其中 Sampling(让 Server 反过来借用 Client 连着的模型帮自己生成内容)和 Logging(Server 给 Client 发日志)在最新协议版本里都被标成了 deprecated。
Sampling 当初存在的理由是:写 MCP Server 的人不一定想自己接入某个 LLM 的 API、管理密钥,不如直接借用 Host 那边已经连好的模型。但现在调用一个 LLM API 已经便宜又容易,这个”借用”带来的协议复杂度(多一轮请求-响应、模型能力不确定)已经不太划算。Logging 也类似。MCP 专门定义一套日志通知机制,其实和已经很成熟的 stderr、OpenTelemetry 做的是同一件事,没必要重新发明一遍。
这两个弃用决定能在 MCP 自己公开的 Design Principles 里找到对应的原则:一条叫 “Capability over compensation”——不为了弥补生态当下的短板去增加协议的永久复杂度,短板通常会随时间自己消失,复杂度却会一直留着;另一条叫 “Standardization over innovation”——已经有成熟方案的事情,不需要在协议里另起炉灶。
这份 Design Principles 里还有一条讲法很直接,叫 “Stability over velocity”:往协议里加东西很容易,删东西几乎不可能,所以每一次新增都当成永久承诺来对待,宁可这次说”不”,也不要仓促说”是”。这个态度在 AI 工具圈子里其实挺少见。大部分 Agent 框架、Prompt 技巧都是按周迭代,MCP 反而主动选了一条慢节奏。
生态:Registry、SDK、参考实现
配套的几块基础设施都比较直白:官方给 10 种语言提供了 SDK(TypeScript/Python/C#/Go/Rust 是第一梯队),都支持创建 Server、创建 Client、走本地或远程连接;Sample MCP Server Implementations 是官方维护的 7 个参考实现(Everything、Fetch、Filesystem、Git、Memory、Sequential Thinking、Time),想看真实代码长什么样可以直接去仓库里翻。
Assignment:Action Item Extractor
这周的 Assignment 是在一个现成的 FastAPI + SQLite 小应用上做 5 个 TODO,这个应用做的事情很简单:把一段随手记的笔记,提取成一条条待办事项。跟着 Claude Code 一起完成,思路如下。
TODO 1:实现 LLM 版本的提取函数
现有的启发式函数靠正则和关键字前缀识别待办,能处理”- 买牛奶""TODO: 写周报”这类格式明确的输入,但碰到”今天要把登录的 bug 修了,然后记得给 HR 发邮件请假”这种没有任何格式标记的自然语言就抓瞎了。这道题要写一个 LLM 版本,让本地跑的 llama3.1:8b 通过 Ollama 读懂语义,而不是靠格式匹配。
关键在 prompt 怎么写:直接问模型”提取待办事项”容易换来一段夹杂解释文字的回答,没法直接喂给下游代码用,所以在 system prompt 里把输出格式钉死——只返回一个 JSON 字符串数组,不要任何其他文字;代码这边再做一层保底,先剥掉模型可能自己加的 markdown 代码块包裹,再解析 JSON,解析失败就返回空列表。实测同样那句自然语言输入,LLM 版本正确拆出了”修登录bug”和”给HR发邮件请假”两条,这正是启发式版本做不到的地方。
TODO 2:给新函数写单元测试
思路是覆盖启发式版本已经测过的几种格式(bullet、关键字前缀、checkbox),再专门加一条纯自然语言、没有任何格式标记的中文输入,确保 LLM 版本真的能处理启发式版本处理不了的情况。
TODO 3:重构后端代码
按官方给的几个方向重新分层:配置单独拆成一个文件,请求/响应格式用 Pydantic 定义(而不是到处传裸字典),数据库操作收进一个 context manager,成功自动提交、出错自动回滚,路由按资源拆成两个文件。思路是让”处理 HTTP 请求”和”读写数据库”这两件事彻底分开,改一头不用担心牵连另一头。
TODO 4:接两个新接口
一个 POST /action-items/extract-llm,直接复用已有的提取流程,只是把提取函数换成 TODO 1 写的 LLM 版本;一个 GET /notes,用来看历史笔记。前端各配一个按钮。这一步是把前面几步的成果串起来暴露给用户。
TODO 5:生成 README
让 AI 通读整个代码库,自动生成一份 README,覆盖项目是做什么的、怎么搭环境、有哪些接口、怎么跑测试。这一步反而最能体现”AI 读代码库产出文档”这件事本身的价值:不用自己一条条翻代码找环境依赖、接口参数,直接让 Claude Code 读完项目结构,再对着实际起服务测出来的真实请求/响应核对一遍,转成一份可以直接照着操作的文档。