Week 1 讲 LLM 怎么练成,Week 2 讲 Agent 怎么靠 MCP 拿到训练时不具备的能力。这周的 6 篇 reading 表面上话题很散:写规格、上下文管理、Agent 的能力边界、真实工程师的工作流、怎么设计好一个工具。但合在一起看,其实在回答同一个问题:AI 能替我们干的事越来越多,人到底还剩下什么活要干?人没有闲下来,判断力只是一直在往上游搬家。
从”写代码”到”写规格”:判断力去哪了
放在几年前,写代码和写需求文档是两拨人的活。现在这条线正在模糊:一个不懂技术的 PM,靠 AI 编程工具几分钟内就能把一个功能做出来,不用等工程排期。传统软件开发里,源代码是真理来源,规格文档写完就基本作废;现在这个关系反过来了——规格才是真正值钱的东西,代码只是规格的一次投影,规格写得足够清楚,理论上能重新生成出任何语言的实现。
这也让开发流程本身变了样。旧的流程是:模糊想法 → 画线框图 → 出设计稿 → 拼 MVP → 收集反馈 → 痛苦地改规格 → 推倒重建,每一轮都很贵。新的流程是:模糊想法 → 快速出原型 → 拿给客户看反馈 → 把想法收敛成一份清楚的规格 → AI 辅助直接实现,反馈循环从几周缩短到几分钟。这也是为什么会有”公司里 PM 数量应该是工程师两倍”这种说法流传:工程师照样需要,只是”把想法讲清楚”这件事的产出比过去高太多了。
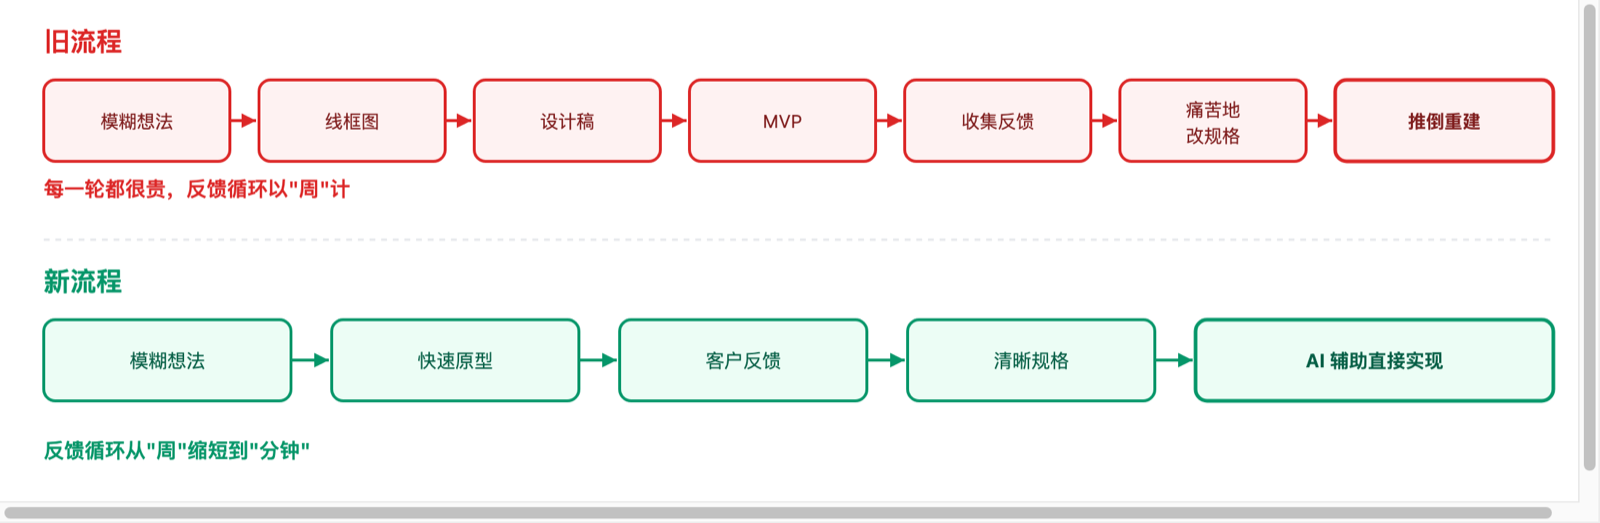
但这篇文章自己也留了口子:规格写得模糊,只会换来一个混乱的代码库;任务越复杂,越需要真正懂行的人判断该往哪个方向、用什么架构。写规格这件事本身,需要的判断力和直接写代码差不了多少。一份”真正好”的规格,得覆盖边界情况、非功能性需求、失败模式,这些恰恰是不懂行的人根本想不到要写的东西。规格并没有取代工程判断力,只是让判断力搬了家,从”写每一行代码”搬到”写规格、审查产出”这两端。简单任务上,这次搬家几乎无痛,谁都能说清楚”做一个待办事项列表”;任务越复杂,能写出”真正好”的规格所需要的判断力,就越逼近直接写代码所需要的判断力。这也是为什么 PM 和 Engineer 的边界看起来在消失:在简单任务上确实消失了,但复杂任务上,这条边界只是换了个地方重新出现。
给 AI 划边界,是为了不让它出错
判断力搬到规格层,不代表可以放任 AI 自由发挥。上下文一旦失控,会以几种很具体的方式失效:
- 中毒(Poisoning):错误信息一旦进入上下文,会被反复引用、越滚越大。Gemini 玩宝可梦时产生过幻觉,这段幻觉留在上下文里之后,模型开始追着一个根本实现不了的目标死磕。
- 分心(Distraction):上下文太长,模型开始依赖历史而不是训练知识。Gemini 超过 10 万 token 后,倾向于重复过去的动作而不是重新规划;Llama 3.1 过了 3.2 万 token,表现明显下滑。
- 混淆(Confusion):可选项太多,模型选不准。这个问题今年在 MCP 生态里表现得格外具体:三个 MCP Server(GitHub、Playwright、IDE)一起挂上,能吃掉一个 20 万 token 窗口 72% 的空间,工具选择的准确率会从 43% 掉到 14% 以下;Cursor 的生产数据显示 40 个工具就是硬上限,Claude Code 过了 50 个工具开始明显降级,OpenAI API 干脆把上限定在 128 个。
- 冲突(Clash):新信息和早前的假设直接矛盾。微软和 Salesforce 的研究发现,分阶段给信息会让平均表现掉 39%,因为模型在前几轮做出的错误假设很难被自己推翻。
这四种失效模式里,“混淆”正好能解释 Week 2 一个一直没深谈的问题:MCP 为什么要把能力拆成 Tools、Resources、Prompts 三种,而不是一股脑塞进”Tools”。拆开之后,模型在决策时真正要过一遍脑子的选项数量变少了——如果什么都算 Tool,模型光是分辨”这条到底是能执行的动作还是一份摆着的数据”就要多费一层判断。MCP 的架构文档里也提到,连着很多 Server 的 Client 应该做”渐进式工具发现”而不是一次性全部加载,这和下面要说的解法是同一个思路。
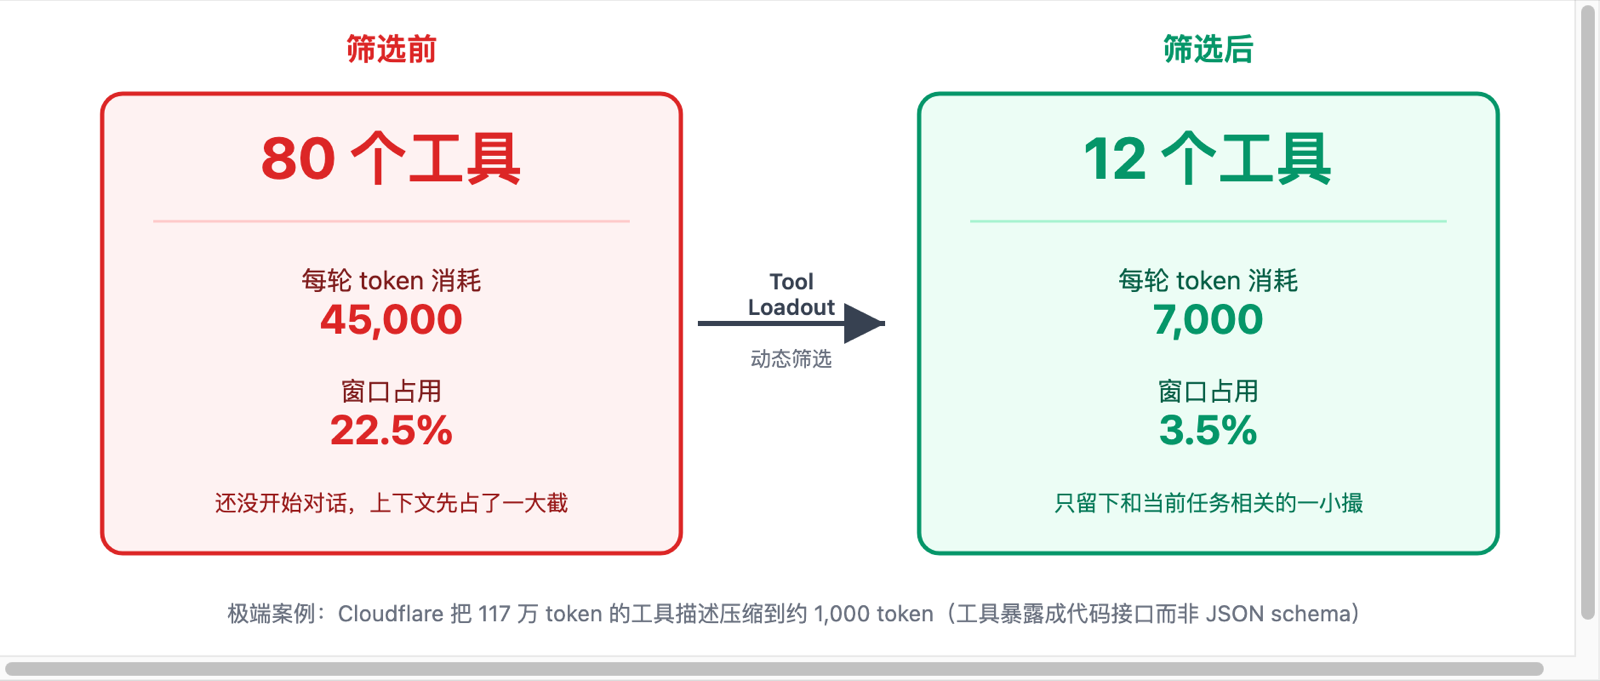
应对办法也有了名字和数据支撑:Tool Loadout,不一次性塞所有工具定义,用检索动态挑出和当前任务相关的一小撮——一个从 80 个工具筛到 12 个常驻的真实案例里,每轮 token 消耗从 4.5 万降到 7 千,窗口占用从 22.5% 降到 3.5%;Cloudflare 甚至做到把 117 万 token 的原生工具描述压缩成约 1000 token,办法是把工具暴露成可执行代码接口而不是一大堆 JSON schema。Context Quarantine,把任务拆成独立子任务,各自开一个干净的线程或 Agent 去处理,避免互相污染——Anthropic 自己的多 Agent 研究系统用这招,比单 Agent 系统提升了 90.2%。此外还有专门删除无关内容的 Context Pruning、面向长对话的 Context Summarization、把信息挪到上下文之外的 Context Offloading。说到底都在干同一件事:只把真正需要的塞进上下文,剩下的筛掉。
“Junior Partner”这个说法,一年后还成立吗
这批 reading 里有一篇写于 2025 年的文章,把 coding agent 定位成”初级搭档”——目标是帮人省下约 80% 的时间,而不是完全自动化;文章也坦白承认,当时的 agent 调试能力弱、视觉推理差、知识有截止日期。放在一年后的今天回头看,这篇文章的判断,有的地方站住了,有的地方已经明显过时。
视觉推理这条基本可以划掉了——文章写作的时候,模型看图能力普遍弱,需要用设计系统之类的办法绕开;现在主流前沿模型基本都原生支持多模态,直接甩一张截图或一段录屏过去,已经不是什么门槛。
“初级搭档”这个定位本身,正在被这个月刚发生的两件事挑战。9 月 14 日,DeepSeek 的机器学习系统工程师刘胜与发了一篇长文《我不得不把才华埋葬在昨天》,说他刚交付完 DeepSeek V4.1 核心 Attention 算法,判断半年到一年内 AI 写的算子会和他写得一样好,甚至超过他——AI 一秒能处理 300 个 token,人做不到。他没说自己要失业,而是说要转型,从”匠人”变成 AI Agent 的”机甲驾驶员”。9 月 11 日,25 位菲尔兹奖得主(包括陶哲轩、Peter Scholze)联署声明,反对的焦点很具体——AI 公司把数学难题当成跑分基准来抢跑:他们认为解题只是理解力的代理指标,仓促的”agentic 证明”会破坏数学界验证发现、传承知识的机制,还带来了署名和抄袭方面的争议。这两件事凑在一起说明:至少在”能不能独立产出高质量成果”这个维度上,一年前”初级搭档”的判断,正在被最前沿的从业者自己推翻。
不过”省 80% 时间而不是完全自动化”这句判断,可能比”初级”这个标签更扛得住时间——完全自动化真正卡住的地方是判断没法和人对齐,跟执行速度关系不大:一个产品要做成什么样、一篇文章想表达什么,本来就没有唯一正确答案,只能靠更多的交流去逼近,细节可以交出去,但”我到底想要什么”这件事,AI 替不了人做决定。这条反而是这批 reading 里最没有过时的一句话。
高杠杆的地方,才值得人花时间
前两节说的是判断力去哪了,这一节说人的时间该花在哪:花在研究和规划上,不是逐行看 AI 写的代码。
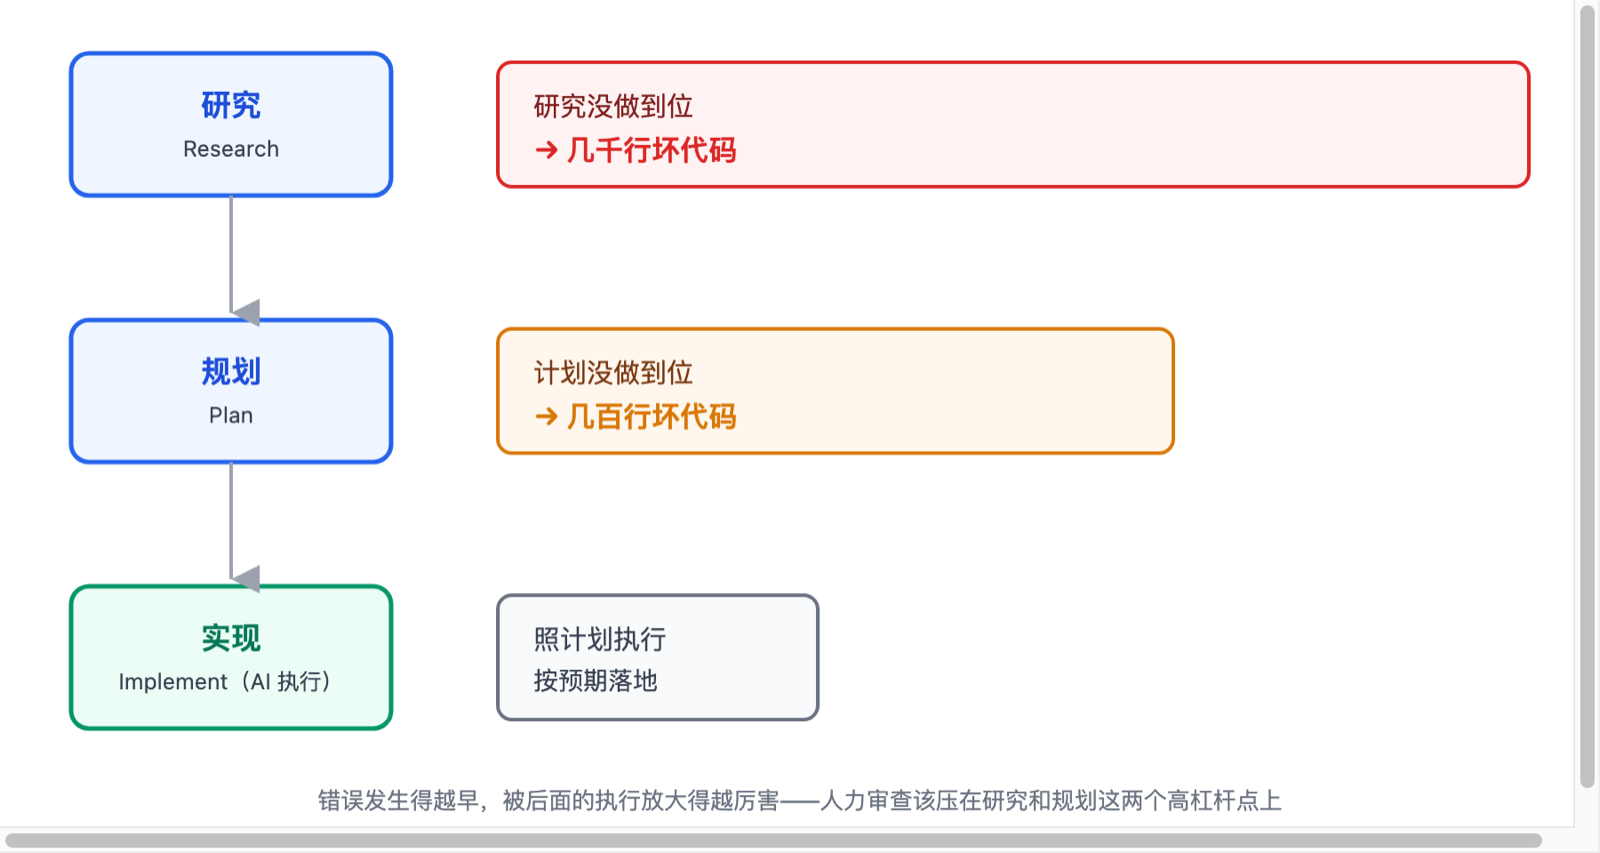
具体做法是三段式:先研究(弄清楚代码库、相关文件、信息怎么流动),再规划(精确写清楚要改哪些文件、怎么验证),最后才是实现,全程把上下文利用率控制在 40%-60%,不让信息过载。这套流程背后有一个很直接的杠杆逻辑:一个糟糕的研究能带来几千行坏代码,一个糟糕的计划能带来几百行坏代码,错误发生得越早,被后面的执行放大得越厉害。所以人力审查最该压在研究和规划这两个高杠杆的点上,而不是等代码写出来之后再逐行看——这在几年前可能还算反直觉,放在现在已经不算了:AI 一次能生成一大堆代码,没有人真的看得完,等看完这一批,下一批又出来了,逐行审查这条路径本身已经跑不通。
真实数据也很说明问题:作者作为 Rust 业余开发者,第一次接触一个 30 万行的 Rust 代码库,1 小时内就提交了一个被维护者批准的 PR;团队里的实习生第一天交出 2 个 PR,第八天做到 10 个。文章也没有回避失败案例——研究不够深入,导致对另一个项目的依赖关系判断错误,说明这套方法不是万能的,前提仍然是研究这一步真的做到位。
这套说法不只是一家之言。一个大厂工程师在网上公开分享过自己团队的真实工作流,一共七步:技术设计文档(主体工作)→ 设计评审 → 子系统文档 → 待办和冲刺规划 → 先写测试再用 Agent 实现 → 两人代码审核(AI 辅助)→ 预发布测试再上生产。AI 真正接手的只有”具体实现”和”审核协助”两步,设计、规划、测试框架这些高杠杆的决策,仍然攥在人手里。“先写测试再实现”这个具体做法背后的逻辑也不难理解:在一个足够复杂、边界已经清楚的代码库里,测试能把”我到底要什么”精确地固定下来,不管 Agent 怎么实现,测试通过就基本可信——这跟前面研究规划优先的逻辑其实是同一件事,只是换了一种更工程化的落地方式。
连”设计好用的工具”,也开始交给 AI 自己了
到这里还有一个环节没聊:AI 用的工具本身,是谁在设计、怎么才算设计得好。Anthropic 给了几条具体原则——工具要少而精,别把现有 API 简单包一层就算完事;用前缀做好命名空间隔离,减少相似功能互相干扰;返回语义化的信息而不是裸的技术 ID,能明显降低瞎编的概率;控制好每次返回的 token 量;工具描述哪怕改一两句话,效果也可能很不一样。
最后这条不是说说而已,Anthropic 自己就撞上过:刚上线 Claude 的网页搜索工具时,发现 Claude 总是自作主张在搜索词里加上”2025”这个年份,拖累了搜索结果——问题不在模型,在工具描述没讲清楚”这个工具自己会处理时效性,不用你手动加年份”,补上这一句话,问题就消失了。评估的做法也很直接:造一批需要多步调用工具的真实场景,跑一遍收集准确率、耗时、token 消耗这些指标,回头看 Agent 的推理过程有没有反复横跳或者选错工具,再迭代工具设计——Anthropic 原文甚至直接建议,可以让 Agent 自己分析这些结果,反过来帮你改进工具本身。
这句话说得轻描淡写,但值得多想一层:连”怎么把一个工具设计好”这件事,现在也开始被 AI 自己接管了。这正是这几家公司在公开谈的”递归自我改进”(RSI)——Anthropic 披露,Claude 已经在写自家代码库里超过 80% 的合并代码,在一项研究任务上,Claude 自己的迭代循环补上了 97% 的性能差距,而两名人类研究员一周只补上 23%。
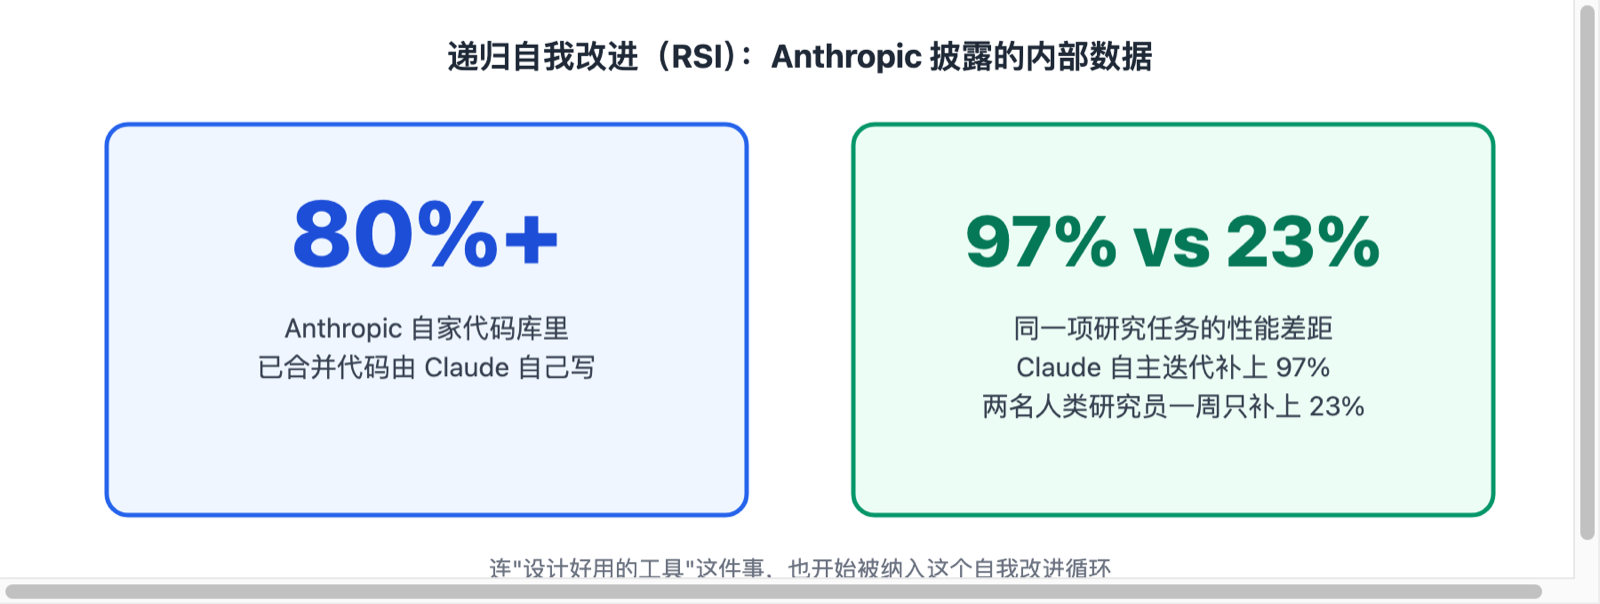
如果连”设计工具”这种感觉上最需要人类审美和判断的活,AI 也能自己越做越好,那前面几节说的”判断力搬到规格、搬到边界设计、搬到研究规划”,下一步会搬到哪,现在还没有答案——这大概也是这门课接下来几周要慢慢回答的问题。
Assignment:给 MCP Server 接一个真实的股票行情 API
这周的作业是给一个真实的外部 API 包一层 MCP Server,让 AI 应用能直接用它查数据。目标不是”调通一次 API”这么简单:作业明确要求把第三方服务失败、超时、被限流这些真实情况处理好,还要同时支持本地和远程两种连接方式,认证和部署算加分项。选的是 Finnhub,覆盖股票、外汇、加密货币行情,免费额度是每分钟 60 次调用。
难点主要在两块:一是外部 API 本身不太规矩——查一个不存在的股票代码,Finnhub 不会报错,只会把所有数字字段都填成 0,得自己识别这种情况、转成明确的”没找到”;二是”可靠”这个要求比听起来重——免费额度说完就完,请求会超时,服务偶尔会挂,这些都不能让调用方看到一堆看不懂的报错。
选 API、设计这几个 tool 该长什么样、想清楚出错时该怎么处理,这些判断自己来做;跟 Claude Code 一起把要做的事按评分维度拆成一份 TODO——功能实现、可靠性、开发体验、代码质量、加分项各自列清楚,再一项项做完,具体的实现、测试、调试全部交了出去。每个维度实际做了什么、用了什么技巧,值得说清楚:
功能实现:5 个 tool 各管一件事——搜代码、查报价、查公司信息、查财务指标、查新闻。Finnhub 原始返回的字段名很难读(价格字段直接叫”c""h""l""o”这种缩写),每个 tool 背后都有一层数据模型,把这些字段翻译成”现价""最高""最低”这种一眼看懂的名字。前面说的”不存在的股票代码返回全 0”这个情况,也是在这一层被识别出来,转成明确的”没找到”结果。
可靠性:这是分量最重的一块。所有可能出的错——没找到数据、被限流、请求超时、上游服务出错——被归成 4 种明确的类型,每种都带着调用方真正需要的信息,比如被限流的时候会说清楚大概还要等多久。不管出什么错,工具最终返回的都是一个结构清楚的结果,不会让一段看不懂的技术报错直接扔出去。为了不把免费额度用超,客户端这一侧自己先做了一层限流——用滑动窗口记着最近的调用时间,快到 60 次这个上限时主动拦下来,不用等 Finnhub 真的报错才知道超额;请求超时的话,会自动重试一次再放弃,不会一遇到网络抖动就直接宣告失败。
开发体验:文档里把两个容易混的密钥说清楚了——一个是调用这个 Server 本身需要的密钥,一个是这个 Server 调用 Finnhub 需要的密钥,两者完全独立;本地和远程两种跑法、每个工具的参数和真实返回示例,都写全了。
代码质量:代码按职责拆成好几个小文件——数据模型、错误类型、限流器、HTTP 调用逻辑、工具本身各自独立,全部带类型标注,过了自动化的代码规范检查。
加分项(认证做了,远程部署没做):认证部分有个挺讲究的细节——校验密钥用的不是普通的字符串比较,而是专门防时序攻击的比较方式,即使密钥错误,校验花的时间也不会暴露出”错在第几位”这种线索,理论上更难被暴力破解。这块认证逻辑刻意做成最原始的中间件形式,不借助上层框架的封装,为的是不干扰这个连接方式特有的流式响应。本地和远程两种连接方式背后共用同一套工具逻辑,不需要维护两份。
验证也没有停在”跑完说测试通过了”这一步。56 个单元测试全部确认通过;另外用官方 MCP 客户端真实起了一次连接,把 5 个工具挨个调用一遍,包括一次故意传错的股票代码。查询 AAPL 拿到的是真实数据:
现价 336.13,最高 338.49,最低 332.53
较前一交易日下跌 0.26%
传一个不存在的股票代码,收到的是结构化的错误提示,而不是报错崩溃:
{"error": "symbol_not_found", "message": "No data found for symbol 'NOTREALTICKER'"}参考资料
- Sean Grove(引用于)Specs Are the New Source Code
- Drew Breunig,How Contexts Fail and How to Fix Them
- Drew Breunig,How to Fix Your Context
- Cognition / Devin,Coding Agents 101
- HumanLayer,Advanced Context Engineering for Coding Agents
- Reddit r/vibecoding,How We Vibe Code at a FAANG
- Anthropic,Writing Effective Tools for Agents
- Anthropic,When AI Builds Itself
- Unblocked,How Many MCP Servers Is Too Many? The Tool Overload Problem
- 刘胜与,《我不得不把才华埋葬在昨天》,凤凰网转载
- Scientific American,25 Winners of Math’s “Nobel Prize” Decry the AI Invasion of Their Discipline